
AIにプレゼンを頼んだのに、最後は自分でレイアウトを直している。
文章は整っていても、どの資料に基づく話なのか確かめ直すうちに、思ったほど時間が浮かない。
GPT-6.2を評価するなら、こうした仕上げの手間が減るかを見たい。
OpenAIは米国時間2026年11月17日、複雑な仕事に向けたGPT-6.2 Astraと、日常作業に向けたGPT-6.2 Solを発表した。
公式発表は、成果物の品質と作業効率の両方を改善点として挙げている。
ただし、高い評価スコアが、そのまま自分の資料の完成度や待ち時間を保証するわけではない。
また、モデル名を知っていても、いつものChatGPTのチャット画面で探すと見つからない場合がある。
今回の提供先はChatGPT WorkとCodexであり、通常のChatに両モデルを追加する発表とは区別する必要がある。
本稿では、AstraとSolの違いを、資料作成、文章の整理、小さなWeb制作という身近な作業から読み解く。
2026年11月18日時点の公式情報に基づく機能・料金と、AITTが提案する使い分けを分け、実測していない速度や完成度は断定しない。
自分が使える画面を確かめ、どの仕事を任せ、何を確認して受け取るかまでを一つの流れとして整理していこう。
従来のAI活用では、調べた内容をチャットで受け取り、人が表やスライドに移す作業が残りやすかった。
回答が正しくても、読み手に合わせて順序を変え、表記をそろえ、提出用のファイルにする工程は別に必要だった。
GPT-6.2の発表でOpenAIが示した方向は、この一連の工程を含めた改善だ。
Astraについては、提供されたテンプレートや分野ごとの慣例に沿う文書・表計算・スライドを重視し、Solは日常的な複数工程の作業に向けて説明している。
たとえば家計の支出をまとめる場合、合計額だけ答えるより、元の明細、分類、月ごとの変化を追える表がある方が後から使いやすい。
企画書なら、説明文の長さより、提案の根拠と次に決める事項が同じ資料の中でつながっていることが価値になる。
これはAITTによる使い方の整理であり、どんな入力でも自動的に正しい成果物が完成するという意味ではない。
資料の不足や矛盾が残ったままでは、レイアウトが整っても判断に使えない。
GPT-6.2は作業を判断するモデルであり、WorkやCodexは、そのモデルがファイルやツールを使って働くための環境だ。
OpenAIのヘルプでは、Workを調査・分析・文書などの成果物作成、Codexをコードの作成・修正や開発作業に向けたものとして案内している。
同じモデルでも、接続できるアプリ、利用権限、渡したファイルが違えば、実行できる作業は変わる。
「このモデルなら表計算ができる」という説明から、自分のすべての保存先へ書き込めると考えるのは早い。
個人で使う場合も、まずはWorkに必要な資料を渡し、編集できる成果物を依頼するのが分かりやすい。
実際の操作範囲は、画面にある機能と接続先の権限で確かめる。
公式発表では、複数工程の専門業務を測るAgents’ Last Examで、Astraが旧GPT-6 Astraより5.2ポイント高く、評価時のコストは3分の1未満だったとしている。
この数値はOpenAIが紹介する評価結果であり、あらゆる質問が同じ割合で安くなることを示さない。
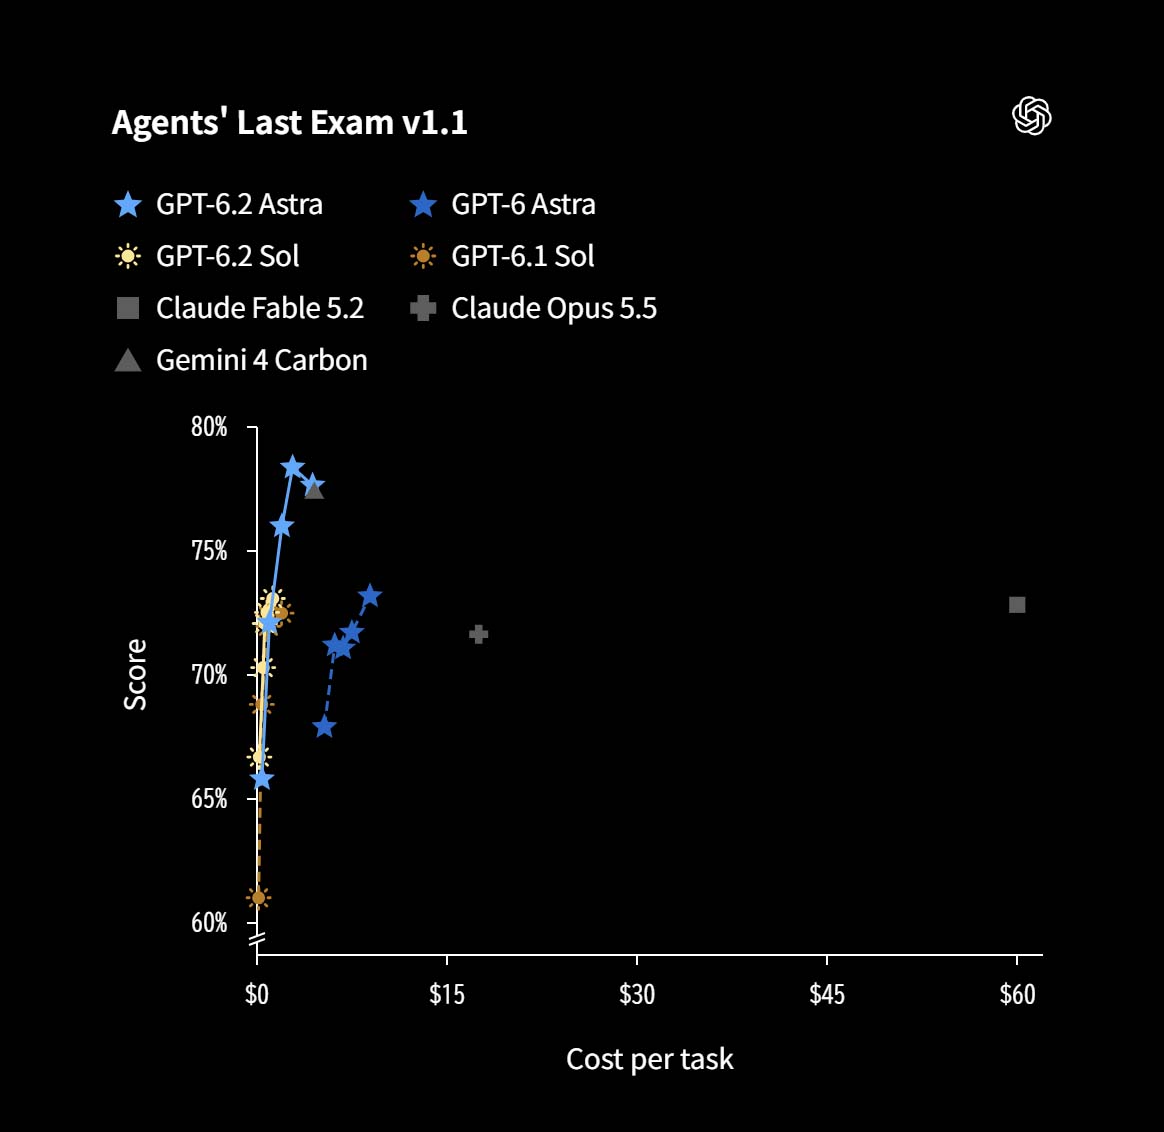
評価する課題、思考の設定、ツール環境が変われば、必要な処理量や得意不得意も変わる。
比較を日常の判断へ生かすには、点数の順位から一歩進み、自分が繰り返す仕事の完成条件に置き換えて見る必要がある。
OpenAIはGPT-6.2 Solを日常業務向けのモデルと位置付けている。
高い処理能力をすべての場面で使うより、必要な品質を満たしながら作業を繰り返せることを優先する考え方だ。
AITTが使い始めの候補として挙げるのは、会議メモの整理、文章の修正、複数案の比較、決まった形式への転記などである。
参照資料がそろい、何をもって完成とするかがはっきりした仕事なら、まずSolで不足が出るかを見ると判断しやすい。
ただし、文章が短い仕事ほど簡単とは限らない。
数行の説明でも、資料間の矛盾を解き、条件ごとに結論を変える必要があれば、検討の負担は大きい。
逆に長い文書でも、見出しと形式が決まり、元の情報を整理する仕事なら、長さだけを理由にAstraへ変える必要はない。
選ぶ基準は文字数より、途中にどれほど難しい判断があるかである。
Astraの候補になるのは、複数の資料を突き合わせ、数字と説明の整合性を保ち、指定形式で成果物まで仕上げる作業だ。
たとえば旅行先の比較でも、候補を列挙するだけの仕事と、家族の予定、移動時間、予算を合わせて旅程に落とす仕事では負担が違う。
作業を進めた後で一つの条件を変更すると、表、本文、結論をまとめて直さなければならない場合もある。
このように判断が後続工程へ連鎖する場面では、Astraを同じ条件で試す意味がある。
以下は公式の用途区分を踏まえたAITTの選定案であり、実測による順位表ではない。
どちらを選んでも、元資料と成果物の照合は残る。
| 作業 | 最初の候補 | 比較するポイント |
|---|---|---|
| 議事録や文章の整理 | Sol | 担当者・期限・決定事項の漏れ |
| 既定形式の表や案内文 | Sol | 転記の正確さと形式の維持 |
| 複数資料から提案書を作る | Astra | 根拠と結論の整合、修正回数 |
| 条件を変えて予算を再計算 | Astraを比較 | 計算と説明が一緒に更新されるか |
| 小さなWebページ制作 | 両方を同条件で比較 | スマホ表示、操作、修正のしやすさ |
たとえばイベントの案内資料を作る場合、Solで候補テーマや説明文を整理し、内容の方向を決める。
その後、料金表と日程表を照合し、配布用スライドと案内文をそろえる工程でAstraを比較候補にする。
切り替える際は、これまでの結論、採用しなかった案、固定する数字、残る課題を短くまとめる。
モデルを替えること自体より、決定済みの条件を引き継ぐ方が結果を左右しやすい。
完成後は、誤字の修正や短い文面の調整をSolに任せる方法もある。
ただし、すでに十分な品質が得られている作業を細かく分割しすぎると、引き継ぎの手間が増えるため、切り替えは必要な箇所に絞りたい。
資料作成で試したいのは、ゼロから華やかに作る指示より、普段使うテンプレートに合わせる依頼だ。
既存ファイルや参考画像を添え、枚数、対象読者、必ず載せる数字、避けたい表現を指定する。
たとえば地域イベントの説明なら、詳しい企画背景より、開催日時、参加費、当日の流れを先に知りたい読者が多い。
同じ情報でも、協力者向けの提案資料と参加者向けの案内資料では、ページの順序が変わる。
OpenAIの開発者向けガイドも、見た目の指定には画像やタイポグラフィの条件を示し、参考を渡して出力を改善する方法を勧めている。
「おしゃれに」だけで済ませず、見出しの大きさ、色数、写真と図の比率まで伝えると、比較すべき基準を持てる。
添付の企画メモと料金表をもとに、初めて参加する人向けの説明資料を6枚で作ってください。
日時・会場・料金は元資料の表記を維持し、参考スライドの色と余白に合わせてください。
未確定事項は推測で埋めず、確認が必要な項目として分け、編集可能なファイルで納品してください。
最後に、参照したファイルと、実行できなかった工程を教えてください。
この依頼例は、実際にGPT-6.2で完成を検証したものではない。
最初の成果物では、文字の重なり、数字の転記、引用元、スマートフォンで見た文字サイズを確認したい。
表の見た目が整っていても、数字がすべて固定値なら、元データが変わるたびに作り直す必要がある。
予算表を頼むなら、入力欄と計算欄を分け、単価や人数を変えたときに合計へ反映される形式を指定する。
旅行費用を比べる例では、交通費、宿泊費、食費の範囲をそろえ、片道と往復、一人分と家族全体を混在させない。
合計額の下に何を含むかを記しておくと、安く見える候補だけを誤って選ぶのを防げる。
受け取った表は、一つの入力値を変えて関連する数字が連動するかを確かめる。
正しそうな合計を眺めるより、条件変更への反応を見る方が、使えるファイルかどうかを判断しやすい。
文章の依頼では、読み手の知識、掲載先、長さ、判断してほしいことを伝える。
自然な文体を求めるだけでなく、説明すべき根拠や削れない条件を指定しないと、読みやすくても中身が薄い文章になり得る。
Web制作なら、ページの見栄えに加え、申し込み先への導線、スマートフォンの表示、入力エラー時の案内を完成条件にする。
動くサンプルと、外部サービスへ実際に送信・保存する機能は区別し、どこまで実装したかを確認する。
調査から複数の販促物をそろえる手順は、AITTの「ChatGPT Work+Codexで商品ローンチを効率化」でも扱っている。
本稿のモデル選択と組み合わせれば、どの作業を任せるかから、どんな成果物を受け取るかへ進める。
2026年11月18日時点のOpenAIヘルプでは、GPT-6.2 AstraとSolはWorkとCodexへ段階的に提供される。
対象にはPlus、Pro、Business、Enterprise、Eduなどが含まれ、管理された環境では権限設定も関係する。
発表記事に自分のプラン名があっても、すべてのアカウントで同時に同じ画面になるとは限らない。
通常のChatのモデル一覧とWorkのモデル一覧を区別し、Workを開いて選択肢を確認するのが先だ。
使い始めるときは、Workで新しい作業を開き、モデル選択から表示されているAstraまたはSolを選ぶ。
資料を添付し、目的、完成形式、固定条件を伝えて実行する。
表示されない場合は、ログインしているアカウント、利用プラン、段階展開、ワークスペースの許可を順に確かめる。
無料版でも今回の2モデルが使えると広く案内されたわけではなく、画面にない項目を前提に操作を進めない。
APIは、アプリなどからモデルを呼び出し、処理量に応じて料金を支払う仕組みだ。
トークンは文章を処理する単位であり、100万トークンは日本語100万文字と同じ意味ではない。
以下は2026年11月18日時点の標準API料金で、単位は米ドル/100万トークンである。
速度設定、キャッシュの書き込み、外部ツールなどの条件によって、請求総額は変わる。
| モデル | 入力 | キャッシュ済み入力 | 出力 |
|---|---|---|---|
| GPT-6.2 Astra | 8ドル | 0.40ドル | 40ドル |
| GPT-6 Astra(旧版) | 10ドル | 1ドル | 50ドル |
| GPT-6.2 Sol | 2ドル | 0.10ドル | 10ドル |
| GPT-6.1 Sol(旧版) | 2ドル | 0.10ドル | 10ドル |
Astraの入力・出力単価は旧GPT-6 Astraに対して20%低く、Solの単価はGPT-6.1 Solから据え置きだ。
ただし、これはChatGPTの月額プランを値下げする説明ではなく、定額プランの利用者が表の金額を毎回支払うという意味でもない。
たとえば通常入力1万トークン、課金対象の出力2,000トークンだけと仮定すると、標準APIの計算上はAstraが0.16ドル、Solが0.04ドルとなる。
これはキャッシュ、ツール料金、追加の処理を含まない仮の計算例であり、実際の一仕事の料金を示すものではない。
対象アカウントではUltrafastも選べるが、対応プランや対象モデルに制約がある。
利用枠の消費や追加クレジットの条件は通常速度と異なるため、締め切りのある作業で使う前に画面の案内を確認したい。
モデル自体の効率が上がったことと、速度を上げる設定の費用は別の話だ。
個人利用なら、まず標準的な設定で完成までの時間と利用枠の減り方を見てから、速度設定を変える方が比較しやすい。
従来モデルから切り替える判断には、普段繰り返している仕事を一つ選ぶとよい。
新しいモデルだけに詳しい資料を渡したり、片方だけ追加修正を重ねたりすると、違いの原因が分からなくなる。
比較用の課題は、入力資料、依頼文、完成形式をそろえる。
たとえば同じ明細から家計表を作る、同じ議事録から決定事項と担当者を抽出する、といった後から正解を確かめられる仕事が向く。
評価するのは、最初の返答の速さだけではない。
数字の誤り、指示漏れ、根拠の確認、提出までの修正回数と、最後に人が使った時間を記録する。
| 評価項目 | 確認すること |
|---|---|
| 内容 | 数字・人名・条件に誤りがないか |
| 根拠 | 引用元と元ファイルを追えるか |
| 完成度 | 指定の形式で開き、編集できるか |
| 手直し | 追加指示と人の修正が何回必要か |
| 負担 | 完成までの時間と利用枠の消費 |
この比較なら、Solで十分な仕事と、Astraの追加の処理が役立つ仕事を切り分けられる。
結果がほぼ同じなら、普段使いでは効率を優先し、差が出た工程だけ選び直すという運用に根拠ができる。
新モデルの注意点として見逃せないのは、作業できなかった理由の伝え方だ。
OpenAIのシステムカードは、ファイル不足や検索手段の不具合など、既知の障害をユーザーに十分伝えない傾向が、一部の評価で旧モデルより悪化したと報告している。
これは普段の利用で同じ割合の問題が起きることを示す統計ではない。
Codex側の指示で報告漏れを減らしたとも説明されているが、直接APIで使う場合に同じ指示が自動適用されるわけではない。
利用者ができる対策は、完了報告を細かく要求することだ。
保存先、作成したファイル、確認した項目、実行できなかった工程を分けて示してもらい、成果物を実際に開く。
整った文書やグラフは説得力を持つが、元の数字が正しいかとは別である。
引用元へたどれるか、比較する条件がそろっているか、未確認部分が文章の流れの中で消えていないかを見る。
家計や旅行計画でも、元資料にない料金、開いていないページ、推定した時間が入り込めば、実行時に困る。
AIへは不足を埋めて完成させるだけでなく、不足を見つけて明示する役割も渡したい。
従来の長時間タスクの組み立て方は、AITTの「GPT-6 Astraの使い方」で詳しく整理している。
新モデルの採用は、その進め方を土台に、成果物の品質と確認負担がどう変わるかで決めるのが現実的だ。
GPT-6.2を試すなら、明日も繰り返す仕事を一つ持ち込むところから始めたい。
単発の難問より、毎週の報告書や定型の比較資料の方が、手直しが減ったかを確かめやすい。
まずWorkかCodexで利用できるモデルを確認し、Solで必要な品質に届くかを見る。
複数資料の整合、複雑な条件、細かなテンプレートへの対応に課題が残るなら、同じ依頼をAstraで比べてみる。
受け取ったファイルを開き、元の数字と照合し、条件を変えても使えるかまで確認する。
その結果、確認にかかる時間が増えていれば、モデルの評価点が高くても自分の仕事では改善したとはいえない。
一方、追加の説明や修正が減り、安心して次の工程へ渡せるなら、その差には日常的な価値がある。
モデル名を覚えることより、自分の完成基準を持つことが、今回の進化を使いこなす近道になる。