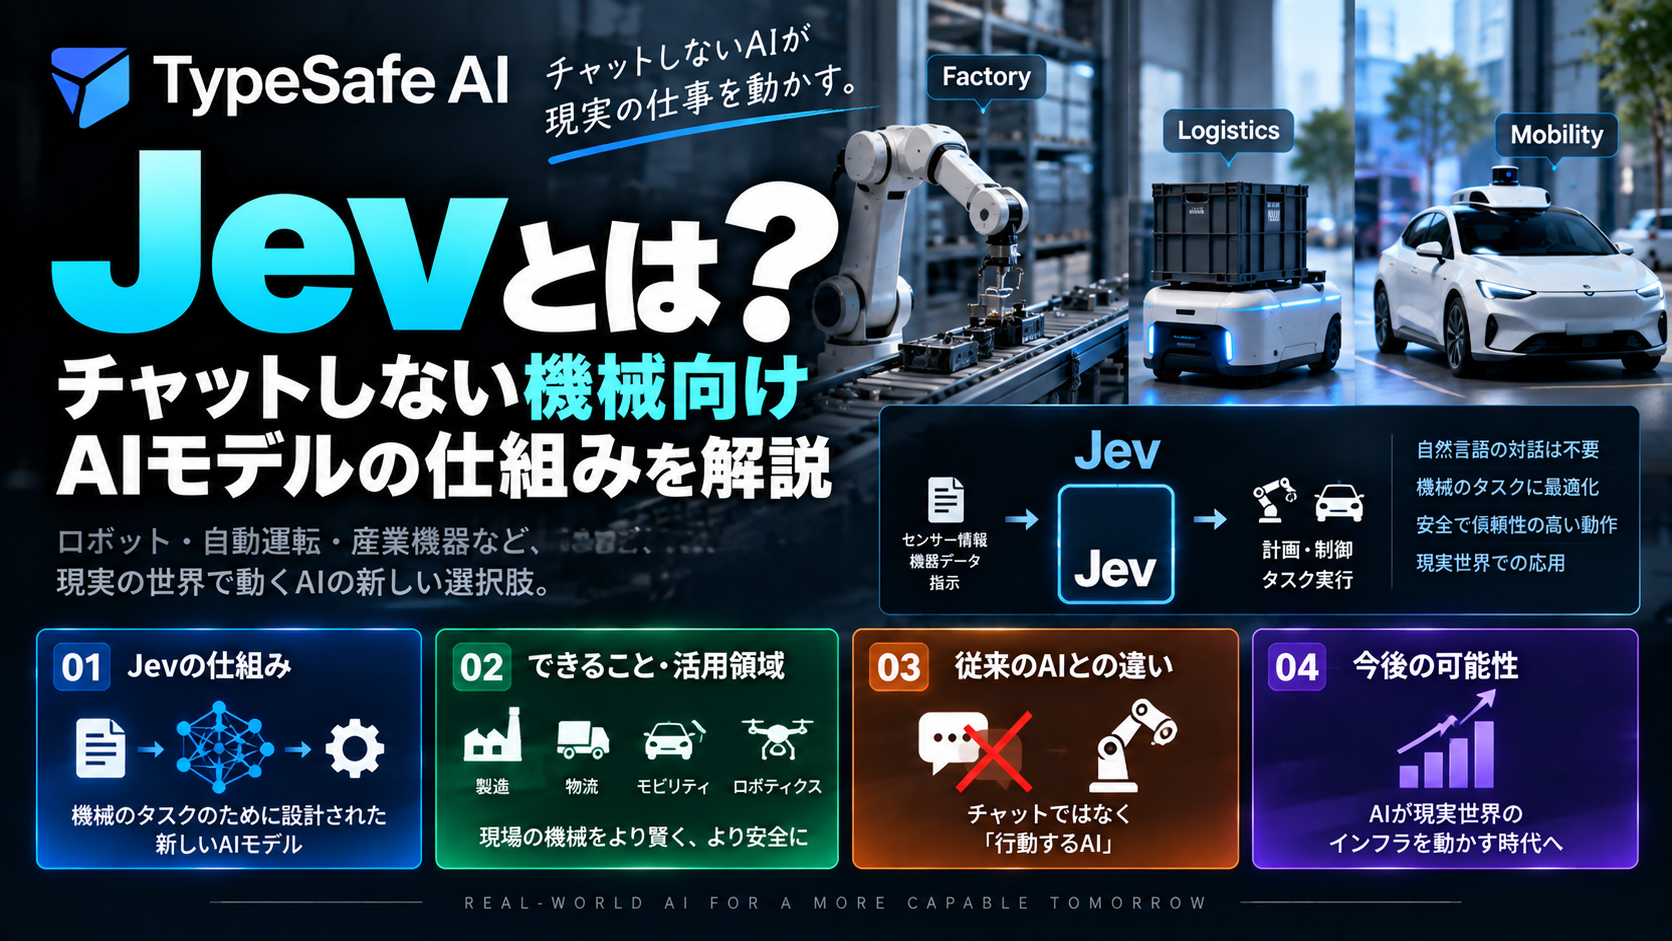


AIモデルと聞くと、ChatGPTのように質問へ文章で答えるものを想像しがちです。TypeSafe AIのJevは、その逆を狙っています。
Jevは長い回答文を作るのではなく、ソフトウェアの中で「どれを選ぶか」「承認するか」「どのモデルへ回すか」といった判断を返すためのモデルです。
人間が読む文章を生成しないことで、軽い判定のために高価なLLMを毎回呼ぶ構成を減らそうとしています。
TypeSafe AIはJevを最初の公開System One Modelと位置づけています。
入力は非構造化テキストでも、出力はあらかじめ定義した型と確率です。
たとえば問い合わせ内容を「請求」「技術サポート」「営業」の3つへ分類する場合、Jevに自然文の説明を書かせて後からJSONへ変換するのではなく、最初から選択肢と確率を返させます。
一般的なLLMは、人に読ませる文章を作る能力が非常に高い一方、ソフトウェアが必要としているのは文章ではなく「この処理を承認するか」「どのモデルへ送るか」「優先度はいくつか」といった小さな判断だけ、という場面があります。
そのたびに長いプロンプトを送り、LLMが文章やJSONをトークン生成する構成は、処理量が増えるほど待ち時間とコストが積み重なります。
Jevはこの部分を、人向け生成ではなく機械向け判断として切り出す考え方です。
Jevの特徴は、型付きの値だけでなく確率やconfidenceを返す点です。
ソフトウェア側は「confidence 0.9以上なら自動処理、低ければ人へ回す」といったルールを組めます。
TypeSafeが公開している代表的なプリミティブにはChoice、Scoreなどがあります。
Choiceは複数候補から1つを選ぶ処理で、モデルルーティングとの相性がよい設計です。
たとえば100件の問い合わせが来たとき、すべてを最上位LLMへ送るのではなく、最初にJevで分類し、簡単なものは小型モデル、難しいものだけ高性能モデルへ送る構成が考えられます。
Jev自身が回答文を書くのではなく、後段の処理を選ぶ役です。
この形では、高価なモデルを本当に必要なケースだけに使えるため、システム全体の平均コストや待ち時間を下げられる可能性があります。
特に大量リクエストを処理するサービスでは、1回あたりの差が小さくても全体では大きな差になります。
複数のLLMを使うシステムでは、簡単な質問は安いモデル、難しい設計判断は高性能モデルへ送る「ルーター」が使われます。
しかし、そのルーター自体にLLMを使うと、分類だけのために数秒と推論トークンを消費することがあります。
Jevはこの前段判定に向きます。入力内容をsimple / medium / complex / reasoningのような型へ分類し、後段のモデルを選ぶ構成です。
Jevが最終回答を書くのではなく、「誰に回答させるか」を決めます。
Jevの特徴は、結果だけでなく確率やconfidenceを返せることです。
分類結果をそのまま必ず実行するのではなく、「0.9以上なら自動処理」「0.7〜0.9は高性能LLMへ再確認」「0.7未満は人へ回す」といった段階的なルールを作れます。
この仕組みを入れることで、速度を優先する部分と安全性を優先する部分を分けられます。
特に承認、課金、モデレーションなど誤判定の影響が大きい処理では、confidenceを単なる参考値ではなくフォールバック条件として設計することが重要です。
DevelopersIOは2026年9月17日、JevのChoiceを使い、4種類の会話サマリを各10回、合計40回分類しました。
結果は40/40で期待したtierと一致し、中央値レイテンシは0.643〜0.674秒、1コール当たり約$0.000025〜$0.000027でした。
翌9月18日にはNeMo Switchyardへ組み込むコードパスでも検証し、40/40一致、中央値0.254〜0.282秒を報告しています。
ただし、サンプルは各tierにつき1パターンで、網羅的な精度ベンチマークではありません。
mediumだけconfidenceが0.57〜0.67と低めだった点も重要です。
これは失敗ではなく、境界ケースで迷いがあることを確率として扱い、低confidenceなら安全側へフォールバックする設計に利用できます。
候補を事前に定義できない仕事、長い説明文が必要な仕事、創造的な文章、複雑なコード生成などはJevの役割ではありません。
Jevは「生成AIをすべて置き換えるモデル」ではなく、生成が不要な判断を別の層へ切り出すためのモデルです。
また、early access段階では、幅広い業界・言語・曖昧な境界ケースに対する精度が十分に公開検証されているわけではありません。
自社データで使う場合は、正解ラベルを持つテストセットを用意し、confidenceの分布や誤分類パターンを確認してから自動化範囲を広げる方が安全です。
TypeSafe公式サイトは、System Oneタスクの特定ワークフロー比較で193.6倍高速、444.6倍低コストとしています。
公式例ではTypeSafe側が0.114秒・$0.000081、比較LLM側が8.566秒・$0.013880です。
この数字を「Jevはどんな仕事でもLLMより193倍速い」と一般化してはいけません。
Jevはそもそも長文生成を捨て、決められた形式の判断へ特化しています。
比較対象となる仕事の種類が違えば倍率も変わります。
TypeSafe公式は入力10億トークンあたり$42、つまり100万入力トークンあたり$0.042と案内しています。
Jevは長文の出力トークンを生成するモデルではないため、通常のLLMとはコスト構造が異なります。
ただしearly access段階なので、正式提供時に料金体系が変わる可能性があります。
本番導入では最新の料金ページを確認してください。
問い合わせ分類、モデレーションの一次判定、承認フロー、営業リードの振り分け、エージェント選択、LLMモデルルーティングなど、「答えの候補や型を事前に定義できる仕事」に向きます。
逆に、メール本文を書かせる、長文を要約する、コードを生成する、自由形式で企画を考えるといった仕事は通常のLLMが必要です。
JevはLLMの代替というより、LLMを呼ぶ前後の判断層として見る方が理解しやすいでしょう。
高速でも誤分類は起こり得ます。重要な承認や高額取引をconfidenceだけで完全自動化するのではなく、閾値を設けて人や高性能LLMへフォールバックする設計が必要です。
また、国内実測の40/40は小規模で分かりやすい4ケースを使った結果です。
日本語入力、曖昧な境界ケース、自社データでは別に評価する必要があります。
Jevを使うときは、自由文のプロンプトだけでなく「どの種類の判断を返すか」を先に決めます。
Choiceは複数候補から1つを選ぶ分類、Scoreはルーブリックに沿って連続的なスコアを返す判定、Noulはある命題が真か偽かを0〜1で評価するプリミティブです。
問い合わせ振り分けならChoice、リスクや優先度の評価ならScore、条件成立の判定ならNoulというように、ソフトウェア側が必要とする型へ合わせます。
一般的なLLMのstructured outputやfunction callingも、最終的にJSONや決められたスキーマを返せます。
ただし内部では通常、言語モデルがトークンを順番に生成し、その結果をスキーマへ合わせます。
Jevは文章生成そのものを目的にせず、定義済みの選択肢や値を確率付きで直接返す設計です。
この違いが速度とコストの狙いにつながります。
メールを1通書くような生成タスクではJevに利点はありませんが、「この問い合わせはどの部署か」「次にどのLLMを呼ぶか」のように答えの空間を事前定義できる処理では、文章を生成する工程そのものを省けます。
TypeSafeはJevについて、文字列を自由生成しないため通常のLLMで問題になるhallucinationやtype errorを避けられると説明しています。
ただし、これは分類や判断が100%正しいという意味ではありません。
実際のシステムではconfidenceを見て、高信頼なら自動処理、低信頼なら高性能LLMや人へエスカレーションする設計が前提になります。
国内検証でもmedium判定は期待した分類に一致しながらconfidenceが0.57〜0.67でした。
このように「答え」と同時に迷いの程度を受け取れることが、単純なJSON出力との差になります。
実装の流れは
①会話やシステム状態をstateとしてまとめる
②Choiceなどで判定基準を定義する
③Jevから選択結果とconfidenceを受け取る
④閾値以上なら処理を続け、未満ならフォールバックする、という形です。
NeMo Switchyardのようなルーティング基盤では、この判定結果を使って後段のLLMを切り替えられます。
まず「この処理は文章を生成する必要があるか」を考えます。
必要がなく、答えの候補や数値範囲を事前に定義できるならJevと相性があります。
次に、1日に何回その判断を行うか、通常LLMでどれだけレイテンシとコストが発生しているかを測ります。
問い合わせ分類、モデルルーティング、一次承認、優先度付けのように件数が多い処理ほど専用モデルへ切り出す効果が見えやすくなります。
逆に1日に数回しか発生しない処理では、システムを増やす複雑さの方が大きい場合があります。
Jevの価値は単体ベンチマークより、システム全体の待ち時間とコストがどう変わるかで評価するのが適切です。
TypeSafe AIが示す高速・低コストの倍率は、System One向けの特定ワークフローを一般的なLLM処理と比較した結果です。
Jevはそもそも長文を生成しないため、同じ仕事をより短い出力で終えられることが大きく効いています。
したがって、この倍率を「JevはあらゆるAIタスクでLLMより数百倍優れている」と解釈するのは適切ではありません。
分類やルーティングのような狭い判断では差が出やすい一方、文章生成やコード生成では比較対象そのものが異なります。
国内検証では日本語のcriteriaを含む分類が正常に動いた例がありますが、それだけで日本語全般の精度を保証できるわけではありません。
敬語、略語、業界用語、曖昧表現などが増えると境界ケースも増えます。
実運用では、実際の日本語問い合わせを使った評価セットを用意し、分類精度だけでなくconfidenceの分布も確認する必要があります。
特に誤判定のコストが高い用途では、日本語専用のしきい値調整や人へのフォールバックを設計すると安全です。
問い合わせ件数が多いSaaS、複数LLMを使い分けるAIサービス、承認や優先度判定が大量に発生する業務では効果を測りやすくなります。
反対に、判断回数が少ない業務では、新しいモデルを組み込む運用コストまで含めて評価する必要があります。
Jevは「ChatGPTより賢いチャットAI」を目指したモデルではありません。
文章生成が不要な判断を、機械が扱いやすい型と確率で返すためのモデルです。
生成AIシステムが複雑になるほど、すべての判断を高価なLLMへ投げる必要はなくなります。
分類やルーティングをJevのような専用モデルへ分離し、本当に生成・推論が必要な場面だけLLMを呼ぶ構成は、速度とコストを見直す一つの方法です。