

「DeepSeekやKimiがClaudeの能力をコピーした」。2026年にAnthropicが公表した不正蒸留の調査は、こう要約されることがあります。
しかし、蒸留という技術自体はAI業界で長く使われてきた標準的な手法です。
大きなモデルの知識を小さなモデルへ移し、推論コストを下げたり、特定タスクの性能を上げたりすることは珍しくありません。
今回の争点は、技術名ではなく取得方法と利用条件です。
Anthropicは、競合ラボが大量の偽装アカウントやプロキシを使い、Claudeへ大規模に問い合わせ、回答や推論痕跡をモデル学習へ使ったと主張しています。
9月の脅威レポートでは、単に人工的なプロンプトを大量投入するだけでなく、他社AIを使っていた実ユーザーの会話がClaudeへ転送され、その往復が訓練資源として保存されたケースもあったと説明しました。
一方で、対象企業側の個別反論は、9月10日時点のReuters取材では確認されていません。
中国側の政府・国営メディアは、蒸留は中立的で一般的な技術であり、米国側の批判は二重基準だと反論しています。
したがって、この記事ではAnthropicの帰属判断を「確定した違法行為」として扱わず、技術としての蒸留、契約・アクセスの問題、ユーザーデータの問題を分けて整理します。
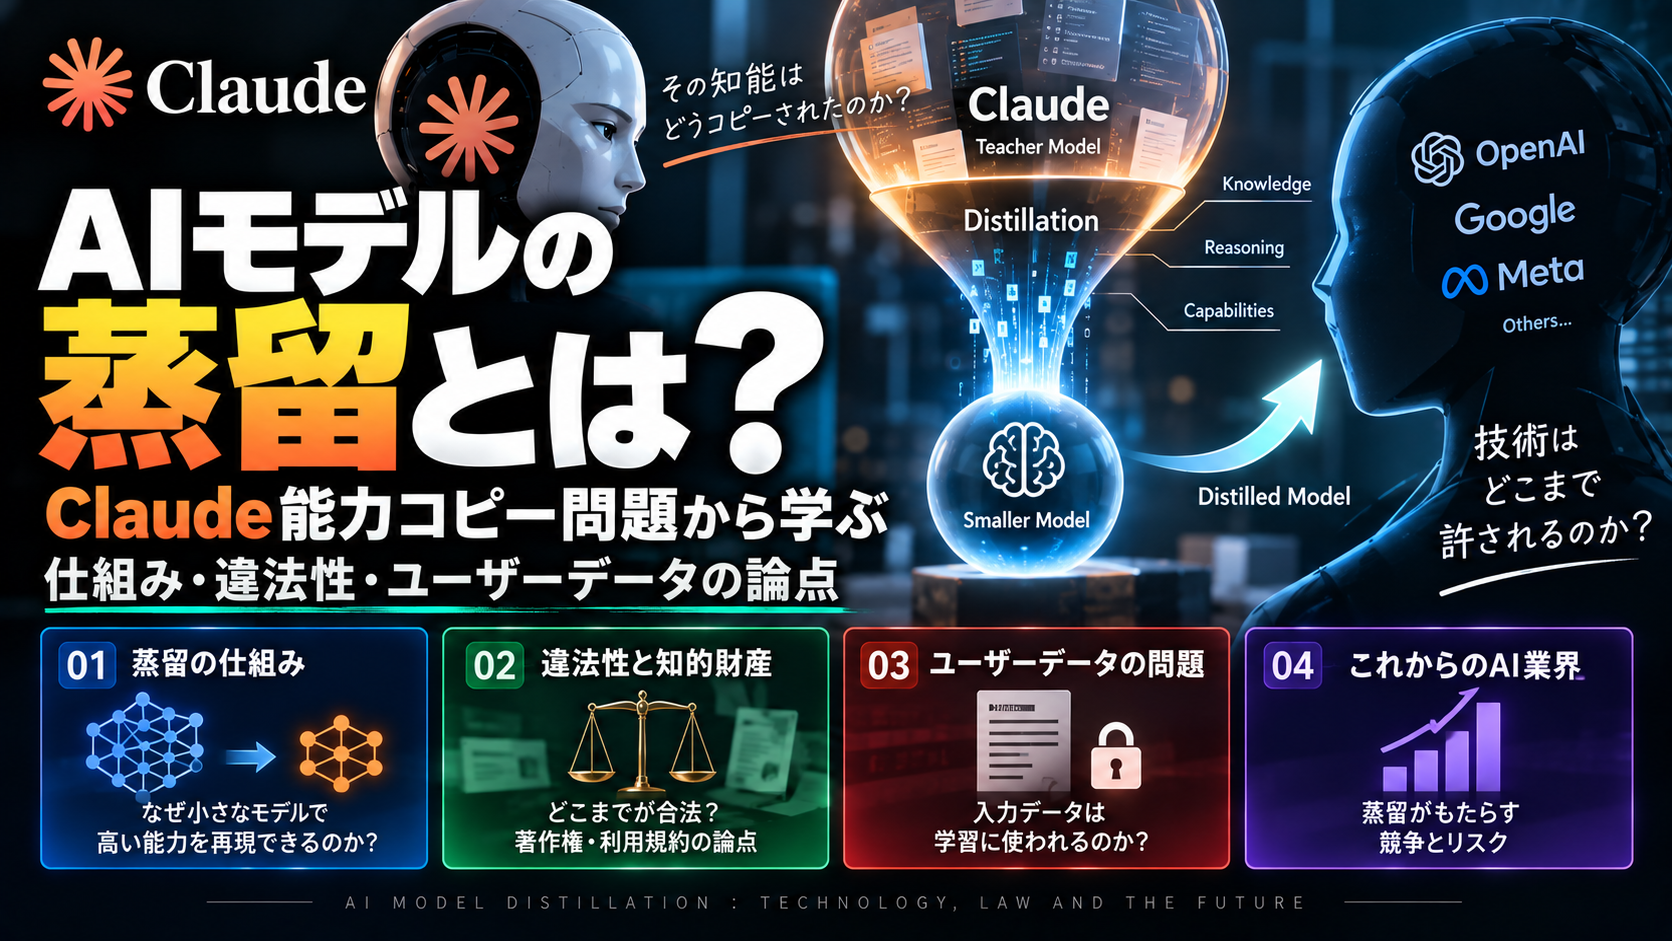
knowledge distillationは、一般に「教師モデル」の出力を使って「生徒モデル」を学習させる方法です。
2015年のHinton、Vinyals、Deanによる代表的研究では、複数モデルや大きなモデルが持つ知識を、より扱いやすい小型モデルへ移す考え方が整理されました。
たとえば、高性能な教師モデルへ大量の問題を解かせ、その入力と回答を新しい学習データとして使います。
生徒モデルは、その正解だけでなく、教師がどの選択肢をどの程度もっともらしいと判断したかといった情報からも学べます。
現在の生成AIでは、単純な分類確率だけでなく、文章回答、コード、ツール利用手順、評価結果なども学習資源になり得ます。
ここで重要なのは、「元モデルのパラメータを丸ごとコピーする」ことと「出力を教材にして似た能力を学ばせる」ことは別だという点です。
後者はモデルの振る舞いを近づけることはできますが、教師モデルの内部構造や訓練データをそのまま複製するわけではありません。
一方、APIの出力を大量取得してモデルの機能を再現する行為は、セキュリティ研究ではmodel extractionとしても研究されてきました。
2016年のTramèrらの研究は、公開APIへの問い合わせからモデル機能をかなり忠実に再現できるケースを示しています。
現在のLLMでは、distillation、synthetic data generation、model extractionの境界が重なる場面もあり、「何をコピーしたか」だけでなく「どの契約・権限で出力を得たか」が実務上の争点になります。
「蒸留が合法か違法か」を技術名だけで決めることはできません。
自社が所有する教師モデルから小型モデルを作る場合、オープンライセンスで許可されたモデルを条件内で使う場合、他社APIの出力を契約に反して大量取得する場合では、前提がまったく異なります。
AnthropicのCommercial Termsでは、サービスを競合製品の構築や競合AIモデルの訓練に使うことを、明示的な承認がない限り制限しています。
したがって、Anthropicが2026年の報告で「illicit」と呼んでいる中心には、蒸留という数学的手法ではなく、規約上禁止された目的、アクセス地域の制限回避、偽装アカウント、大量の自動取得が含まれています。
法律上の評価はさらに複雑です。
出力の著作権、契約違反、不正アクセス、営業秘密、個人情報など、どの論点が成立するかは国・取得方法・データの内容で変わります。
他社AIの回答を一度参考にしただけで直ちに「違法な蒸留」になるわけでも、公開された出力なら無制限にモデル学習へ使えると決まっているわけでもありません。
今回の記事で区別したいのは三段階です。
第一に、権限を持つモデル所有者が自社内で行う蒸留。
第二に、契約やライセンスの範囲内で他モデルの出力を研究・評価に使うケース。
第三に、アクセス制限を迂回し、競合モデル学習を目的に大規模取得するケースです。
Anthropicの報告は主に第三の領域を問題視しています。
Anthropicは2月23日、DeepSeek、Moonshot AI、MiniMaxの3社に帰属するとする不正蒸留キャンペーンを公表しました。
合計で約2万4,000の不正アカウントを通じ、1,600万回を超えるClaudeとのやり取りが生成されたとしています。
対象は推論、コーディング、ツール利用、コンピューター操作など、モデル開発で価値の高い能力でした。
9月の脅威レポートでは、対象がさらに広がりました。
Anthropicは、2月以降に中国拠点の7ラボによる追加のキャンペーンを検知・遮断したと説明し、Alibaba、Moonshot、DeepSeek、Zhipu、Xiaomiなどについて具体例を示しています。
Alibabaに帰属するとした活動は5〜7月に1億5,100万回超、Moonshotは同期間に2,300万回超、DeepSeekは7月の14日間で1,210万回超、Xiaomiは3〜4月の20日間で40万回超などと報告しています。
ただし、これらの数値と帰属はAnthropicの調査結果です。
AnthropicはIP、リクエストメタデータ、インフラ指標、外部パートナーからの情報などを根拠に高い確度で帰属したとしていますが、外部の独立監査で確定した司法判断ではありません。
Reutersが9月10日に報じた時点で、Alibaba、Moonshot、DeepSeek、Xiaomiはコメント要請へ直ちに回答していませんでした。
また、中国側には異なる見解があります。
中国商務省は米国側の大規模な蒸留批判について事実・法的根拠がないと反論し、蒸留は広く使われる中立的な技術だと主張しました。
9月15日には中国国営紙も、米国企業も蒸留を利用しているとして二重基準だと批判しています。
これはAnthropic個別事案の技術的反証ではありませんが、蒸留そのものと「無許可の取得方法」を分けて論じる必要があることを示しています。
9月報告で利用者にとって最も重要なのは、競合企業間のモデル開発競争より、会話データの経路です。
Anthropicは、MoonshotとDeepSeekが一部ユーザーのリクエストを、自社モデルで処理せずClaudeへ転送し、その応答をユーザーへ返すと同時に保存・学習へ利用したと主張しています。
Xiaomiについても、自社ユーザーの会話やコーディングセッションをClaudeへ再投入し、SFTやRL用データの作成に使ったとしています。
Anthropicによれば、これらの会話には企業内部のコード、認証情報、個人名、連絡先、社内データなどが含まれる例がありました。
ここでのリスクは「Claudeが会話を学習したか」だけではありません。
ユーザーがサービスAへ入力した内容が、知らないうちにサービスBのAPIへ転送されれば、データの処理者、保存場所、適用規約が増えます。
しかも現在は、AIルーターやコーディングハーネス、エージェント基盤を通じて複数モデルへ切り替える利用が一般化しています。
画面に表示されるモデル名と、実際に推論を実行するプロバイダーが常に一対一とは限りません。
一例としてOpenRouterは、プロンプトと回答を自社側では原則保存せず、オプトイン時のみログを保持すると説明しています。
一方、実際のモデル提供者ごとに保持・学習方針は異なるため、プロバイダー単位のデータポリシーやZero Data Retention(ZDR)を指定できる仕組みを用意しています。
これは「ルーターだから危険」という意味ではなく、経路が増えるほど利用者が確認すべき契約主体も増えるという例です。
AIサービスを比較するとき、多くの人はモデル性能と料金を見ます。今後はそこへ「データがどこを通るか」を加えた方がよいでしょう。
個人利用では、パスワード、APIキー、未公開の契約、顧客情報、社内ソースコードを、経路が分からないAIへそのまま渡さないことが基本です。
企業利用なら、法人向け契約で学習利用の有無を確認し、許可するモデル・ルーターを一覧化し、ログ保持と削除手順まで運用ルールに含めます。
なお、Claude自体でも個人向けと法人向けでデータ利用条件は異なります。
AnthropicはCommercial Productsについて、デフォルトでは入力・出力をモデル訓練に使わないと説明しています。
一方、消費者向けClaude Free、Pro、Maxは、利用者が許可した場合に新しい会話やコーディングセッションをモデル改善へ使う仕組みです。
サービス名だけで「学習される/されない」と判断せず、契約区分まで見る必要があります。
編集上の判断として、今回の不正蒸留問題は「どのAIが一番賢いか」という競争だけではありません。
AIの出力、推論痕跡、ユーザー会話そのものが高価値の訓練資源になったことで、AIサービスの供給網がデータセットからAPI・ルーター・エージェントへ広がった問題です。
利用者側も、モデル選択と同じくらいデータ経路を選ぶ意識が必要になっています。
AIモデルの蒸留は、古くから使われている正当な機械学習手法です。
大きな教師モデルから小さな生徒モデルへ能力を移し、コストを下げること自体を「盗用」と呼ぶのは正確ではありません。
2026年にAnthropicが問題視したのは、偽装アカウント、アクセス制限の回避、大量取得、競合モデル学習、推論痕跡の抽出といった取得方法です。
9月の報告では、さらに一部ユーザー会話が知らない経路でClaudeへ転送され、学習資源として利用されたとする主張まで加わりました。
この帰属や法的評価は、Anthropicの調査だけで確定したものではありません。
対象企業側の説明、各国当局や裁判所の判断、契約条項によって評価は変わります。
ただし利用者にとっての判断軸は明確です。
モデル名だけを見るのではなく、実際の推論提供者、保持期間、学習利用、第三者共有、ルーティング条件を確認する。
特に機密データを扱う場合は、ZDRや許可プロバイダー固定、法人契約を含めてデータ経路を管理することが重要です。