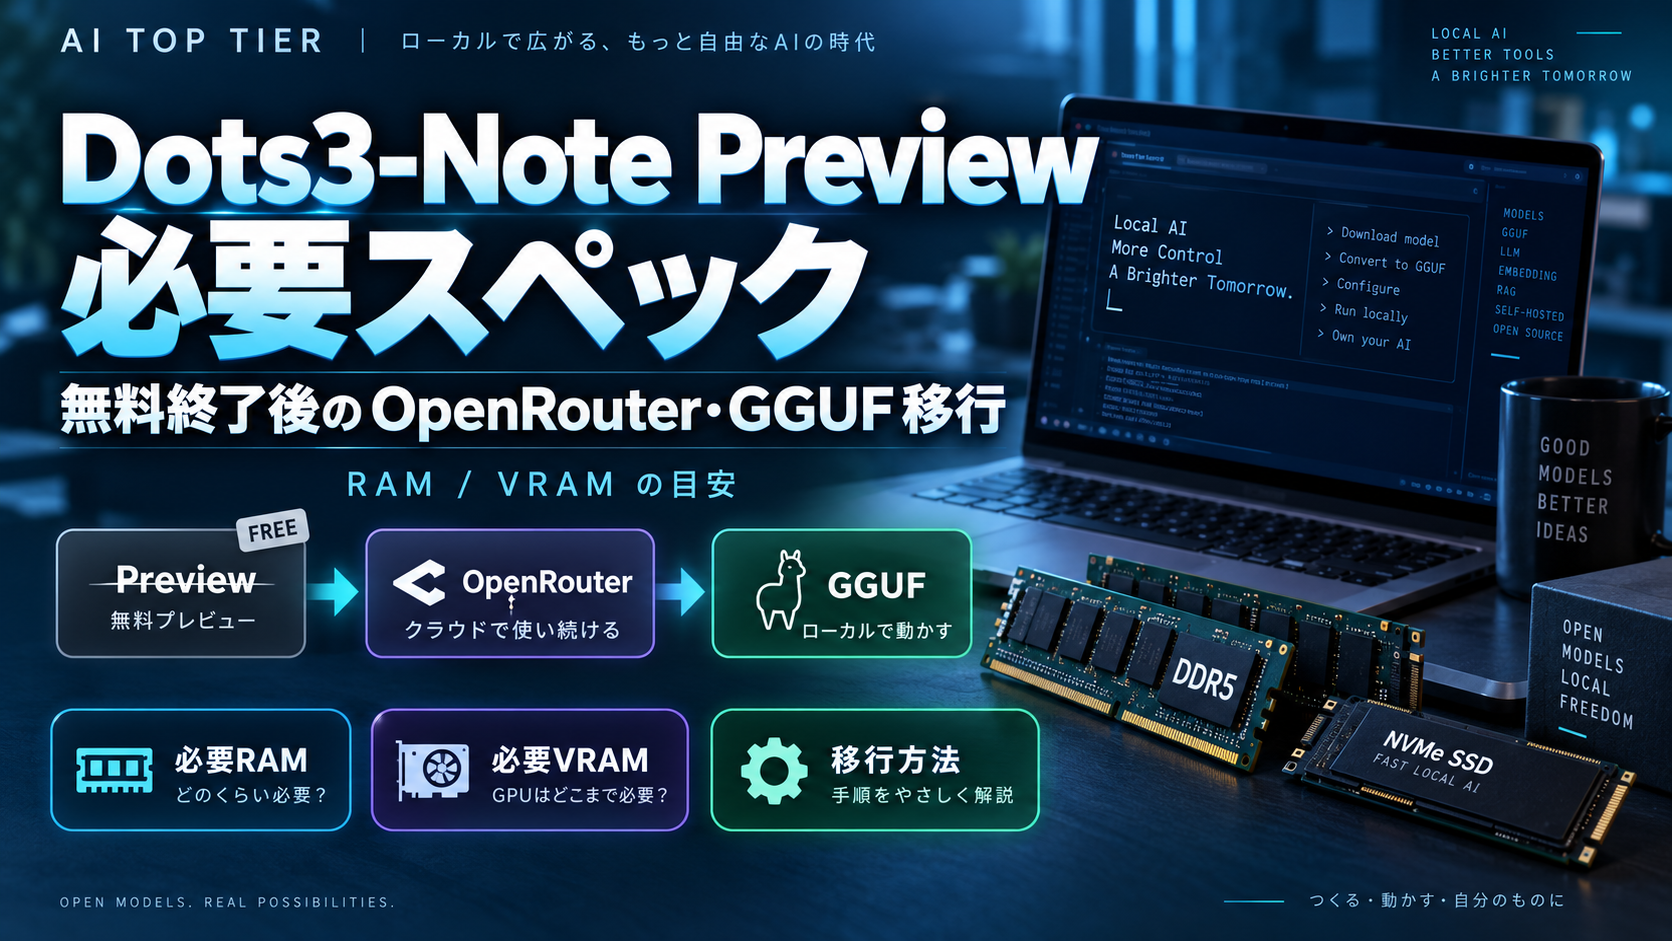


Dots3-Note PreviewをOpenRouterの無料枠で試していた人は、2026年9月30日をひとつの区切りとして考える必要があります。
OpenRouterのモデルページには「Going away September 30, 2026」と表示されており、現在の無料エンドポイントが終了予定です。
ただし、ここで混同しやすいのが「無料APIが終わること」と「モデルそのものが使えなくなること」です。
Dots3-Note PreviewはHugging Faceで重みが公開されているオープンウェイトモデルで、公式モデルカードはApache 2.0を掲げています。
OpenRouterの無料ルートが消えても、モデルファイルまで消えると決まったわけではありません。
悩ましいのは、その先です。Dots3-Note Previewは280B総パラメータ、16B activeという大規模MoEです。
activeが16Bなら中型GPUで動きそうに見えますが、実際には推論時に選ばれる専門家が一部であっても、モデル全体の重みをどこかに保持しなければなりません。
ローカル移行では、ここが最大の落とし穴になります。
この記事では、無料終了の意味を整理したうえで、GGUF量子化別の容量、RAM/VRAMの考え方、CPUオフロード、vLLMとllama.cppの違いまでつなげて解説します。
OpenRouterで終了予定なのは「dots-studio/dots-3-note-preview:free」です。
2026年9月22日時点のモデルページでは、価格は入力・出力ともに0ドル、コンテキストは512K、そして9月30日に終了予定と表示されています。
ここから確実に言えるのは、無料エンドポイントが終了するということです。
一方、終了後に同じモデルへ有料プロバイダー経由でそのまま接続できるかは、現時点では確認できません。
OpenRouter上に有料版が追加される可能性はありますが、記事公開時点で存在しなければ「有料化される」と書くべきではありません。
モデル自体は別です。Dots Studioの公式Hugging Faceには通常版とFP8版のリポジトリがあり、モデルカードも公開されています。
GGUFもggml-orgなどから配布されており、llama.cppから呼び出せる状態です。
したがって、無料API終了後の選択肢は「使えなくなる」ではなく、「どの経路で使うかを選び直す」と捉えるほうが正確です。
クラウド側では、OpenRouter以外のAPI提供先が現れる可能性があります。
ローカル側では、GGUFをRAM中心で動かす方法、複数GPUへ分散する方法、FP8をサーバー向け推論基盤で扱う方法などがあります。
必要なのはAPI料金だけでなく、自分が求める速度と運用の手間を含めて比較することです。
Dots3-Note PreviewはMixture-of-Experts、いわゆるMoEモデルです。
公式モデルカードでは総パラメータ280B、1回の推論で活性化するパラメータは16Bと説明されています。
専門家は256 routed+1 sharedで、各トークン処理時には一部の専門家だけを使う設計です。
ここで「16B active=16Bモデルと同じメモリで動く」と考えると誤解が生じます。
active parameterは計算量の目安にはなりますが、モデルの保存容量そのものを16B相当にしてくれる数字ではありません。
推論の途中でどの専門家が選ばれるかは入力に応じて変わるため、基本的には多数の専門家の重みを利用可能な場所へ置いておく必要があります。
その置き場所がVRAMだけとは限りません。
llama.cpp系なら一部レイヤーや重みをGPUへ載せ、残りをシステムRAM側で処理するCPUオフロードが可能です。
しかし、GPUに収まらない分をRAMへ逃がせば、PCIe転送やCPU処理が増えて速度は落ちます。
もうひとつ注意したいのが512Kコンテキストです。
モデルカード上は最大512Kに対応していますが、長いコンテキストを実際に使うと、重み以外にKVキャッシュやランタイムのワークスペースが必要です。
したがって、モデルファイルが170GBだから「RAM 192GBで必ず512Kまで使える」とは限りません。
短いプロンプトでの起動可否と、超長文を安定運用できるかは別問題です。
ggml-orgのGGUFリポジトリでは、量子化ごとのモデル規模が公開されています。
代表例ではIQ2_XXSが約74GB、Q3_K_Mが約135GB、Q4_K_Mが約170GB、Q5_K_Mが約199GB、Q6_Kが約231GB、Q8_0が約298GBです。
FP8とBF16は単純な理論値でも非常に大きくなります。
280Bパラメータだけを単純換算すると、FP8は1パラメータあたり約1バイトで約280GB、BF16は約2バイトで約560GBが下限イメージです。
実ファイルには埋め込み、各種メタデータ、マルチモーダル側の重みなどもあるため、実運用では余裕を見なければなりません。
以下の表は「モデルを保持するための容量」と「現実的に用意したいメモリ」を分けた目安です。必要量はコンテキスト長、GPUオフロード率、ランタイムによって増減します。
この表で特に見てほしいのは、Q4_K_Mでも約170GBある点です。
32GB級GPUを1枚用意しても、重み全体をVRAMへ載せることはできません。
GPUを高速化に使いつつ、残りをRAMへ置く設計になるのが一般的です。
逆に、192GBや256GBのユニファイドメモリを持つマシンでは「入る可能性」は高まります。
ただし、入ることと快適に速く動くことは同義ではありません。
メモリ帯域、CPU/GPUの実効性能、量子化カーネルの最適化状況を含めて評価する必要があります。
ローカル実行の入口としてわかりやすいのはGGUFです。
ggml-orgのリポジトリではllama.cpp向けの実行例が提示されており、Q4_K_Mなら「llama serve -hf ggml-org/dots3-note-prev-GGUF:Q4_K_M」のようにHugging Faceから直接取得して起動できます。
llama.cppの強みは、GPUだけでなくCPUとRAMを組み合わせやすいことです。
数十GBのGPUしかなくても、200GB前後のシステムRAMを用意し、一部だけGPUへオフロードして起動できる余地があります。
反面、巨大モデルではトークン生成速度がかなり低くなる可能性があります。
vLLM側でもDots3 Noteの実装が確認できます。
とくにサーバー用途では、FP8、複数GPU、テンソル並列などを組み合わせてスループットを取りにいく構成が中心です。
家庭用PC1台で扱うというより、ワークステーションやGPUサーバー向けの選択肢です。
PC構成は大きく3パターンです。
1つ目はRAM重視で、192GB〜256GB級を積み、Q3〜Q4系GGUFをCPU主体または部分オフロードで動かします。
2つ目は複数GPUで、48GB〜80GB級GPUを複数枚使い、可能な限りVRAMへ載せます。
3つ目はAPI継続で、ローカルPCを買わず必要なときだけクラウドで呼びます。
無料エンドポイント終了後に最初に確認すべきなのは、OpenRouter上に有料プロバイダーが追加されたかどうかです。
追加されていれば、既存コードの変更を最小限に抑えられる可能性があります。追加されていなければ、別APIまたはローカル実行を検討します。
ローカルが向くのは、入力データを外部へ送りたくない、継続的に大量処理する、モデルの挙動を細かく調整したい、といったケースです。
一方、週に数回試す程度なら、高額なハードウェアを用意する合理性は薄くなります。
費用比較では総保有コストを見る必要があります。
GPUや大容量RAMの購入費に加え、消費電力、冷却、ストレージ、セットアップ時間、トラブル対応まで含めてください。
クラウドは単価が高く見えても、使わない時間に費用が発生しない点が強みです。
プライバシーについても二択ではありません。
ローカルはデータを自分の管理下に置きやすい一方、セキュリティ更新、アクセス制御、ログ管理まで自分で責任を持ちます。
APIは外部送信が発生しますが、事業者側の保持方針や契約条件を確認すれば、業務用途で管理しやすい場合もあります。
結局、Dots3-Note Previewのローカル移行を考えるうえで最も重要なのは「16B active」という数字だけでPCを選ばないことです。
Q4_K_Mでも約170GB。ここを基準に、必要な速度とコンテキスト長を加えて構成を決めるのが安全です。
2026年9月30日に終了するのは、OpenRouter上のDots3-Note Preview無料エンドポイントです。
モデルそのものはオープンウェイトとして公開されており、GGUFを使ったローカル実行ルートも存在します。
ただし、ローカル移行のハードルは低くありません。280B総パラメータのMoEは、16B activeという数字から想像するより大きなメモリを必要とします。
まずQ3〜Q4のモデル容量が自分のRAM/VRAMに収まるかを確認し、そのうえで速度、512Kコンテキスト、電力、導入コストを評価してください。
公開直前には、OpenRouterの9月30日表示が更新されていないか、有料提供先が追加されていないかを必ず再確認する必要があります。