

これまでローカルLLMは、AIを自分のPCで動かしてみたい技術好きや、機密情報を外部へ送りたくない企業が選ぶ、やや特殊な選択肢と見られてきた。
ところが2026年6月、状況を変える出来事が相次いだ。
米国政府は、AnthropicのClaude Fable 5とMythos 5について、外国籍の利用者や従業員によるアクセスを停止する輸出管理指令を出した。
Anthropicは対象者だけを技術的に切り分けることが難しいとして、結果的にすべての顧客向けアクセスを停止した。
続いてOpenAIのGPT-5.6でも、一般公開が予定どおりには行われなかった。
米政府が安全保障上の評価を理由に公開範囲の制限を求め、GPT-5.6は当初、政府の審査を経た一部の信頼できるパートナーだけへ提供される形となった。
議論の焦点は、モデルの安全性だけではない。
昨日まで使えると思っていたAIが、企業の判断ではなく政府の指令によって突然停止する。
発表された最新モデルが、料金を払う意思のある利用者にも開放されない。
どの国、企業、利用者が使えるかが、性能や契約とは別の政治的判断で決まる。
こうした状況に対し、開発者や利用者からは、規制の透明性、アクセスの公平性、クラウドAIへの依存を懸念する声が出ている。
OpenAI自身も、安全性評価の必要性を認めながら、政府が利用者を選ぶ状態が恒常化することには否定的な姿勢を示した。
そこで改めて注目されているのが、モデルを自分の端末へ保存して使うローカルLLMだ。
クラウドAIは、高い性能、最新情報へのアクセス、画像や音声を含む豊富な機能を提供する。
一方、そのモデルをいつまで使えるか、どの地域へ提供されるか、利用条件がどう変わるかは、ユーザーだけでは決められない。
ローカルLLMでは、一度ダウンロードしたモデルを手元に残し、自分のPCで動かせる。
提供元のサービス障害や月額プランの変更に左右されにくく、対応するライセンスの範囲内であれば、同じモデルを継続して利用できる。
もちろん、ローカルLLMなら政府規制と無関係になるわけではない。
モデルの配布自体が制限される可能性はあり、ライセンス変更、開発停止、ハードウェア規制の影響も受ける。
クラウドの最新モデルと比べれば、性能、速度、使いやすさで劣る場面も少なくない。
それでも、AIを一社のクラウドサービスだけに預けることへの不安が強まるほど、手元で動かせるモデルを持つ意味は変わってくる。
ローカルLLMは、クラウドAIを否定するための選択肢ではない。
使いたいモデルが停止されたとき、料金や利用条件が変わったとき、外部へ送れない資料を処理するときに備える、もう一つの実行環境である。
では、普通のWindows PCやMacで使うなら、どのモデルが現実的なのか。
大きなモデルほど高性能に見えるが、必要メモリ、速度、量子化後の容量、画像対応、日本語性能はモデルごとに異なる。
起動できても、回答を待つたびにPC全体が止まるなら、日常の道具にはなりにくい。
本記事では、メモリ16GBから32GB程度の一般的なPCを基準に、Gemma 4、Qwen3.5、Qwen3、Ministral 3、gpt-oss-20bを比較する。
目的は、単純な性能順位を決めることではない。
クラウドAIへの依存を少し減らしたい人が、自分のPCで継続して使えるモデルを見つけること。
そのために必要な性能と導入負担の境界を整理していく。
ローカルLLMとは、言語モデルのファイルをPCへダウンロードし、その端末のCPU、GPU、メモリを使って推論する仕組みだ。
クラウド型AIでは、入力した文章やファイルがサービス事業者のサーバーへ送られ、サーバー上のモデルが回答を返す。
ローカルLLMでは、対応アプリや関連機能が外部通信を行わない構成にすれば、モデルへの入力と生成処理を端末内で完結できる。
モデルを保存した後は、インターネットへ接続せずに利用できる場合もある。機内、閉域環境、通信が不安定な場所での文章作成や資料整理にも使える。
ただし、「ローカルで動かす」という言葉だけで安全性が保証されるわけではない。
モデルを操作するアプリ、Web検索機能、外部プラグイン、RAGシステム、ログ送信、アップデート機能が外部サービスへ接続する場合がある。
端末がマルウェアに感染していたり、共有設定が不適切だったりすれば、保存した資料が漏れる危険も残る。
データをどこへ送るかを自分で管理しやすいことが利点であり、自動的に安全になるわけではない。
多くのオープンウェイトモデルは、モデルを一回呼び出すたびにAPI料金を請求されない。利用回数が増えても、従量課金が直接積み上がらない点は魅力だ。
一方、運用には別の費用がかかる。
PC本体、GPU、メモリ、ストレージ、電気代が必要になる。インストール、量子化モデルの選定、不具合対応、モデル更新、バックアップに使う時間も無視できない。
すでに32GBメモリのMacや、VRAM 12GB以上のNVIDIA GPU搭載PCを持っている人なら、追加費用を抑えて始められる。
ローカルLLMのためだけに20万円、30万円のPCを購入するなら、数年間クラウドAIへ料金を払う方が安い可能性もある。
費用対効果は、モデルの配布価格ではなく、現在持っている機材と利用頻度から考える必要がある。
本記事では、次の条件を満たすモデルを一般PC向けとして扱う。
専用AIサーバーや複数GPUを前提とせず、メモリ16GBから32GB程度の個人向けPCで、4bit前後の量子化版を読み込めること。
CPUのみ、Apple Siliconのユニファイドメモリ、または一般的なNVIDIA GPUで動作候補になること。
LM StudioやOllamaから入手しやすく、対話や文章作成に調整されたモデルが提供されていること。
動作するだけでなく、日本語で日常的な指示を理解し、文章、要約、整理、簡単な推論へ使えるかも評価に含めた。
必要メモリは、モデルファイルの容量と一致しない。実行時には、モデル本体に加えて次の領域が必要になる。
そのため、「5GBのモデルだから8GBメモリで余裕」とは言えない。コンテキスト長を広げるほど追加メモリも増える。
本記事のメモリ目安は、4bit前後の量子化、短めから中程度の会話、PC上で他の重いアプリを大量に開かない条件を想定した編集上の目安である。
CPU、GPU、OS、量子化形式、使用アプリ、画像入力の有無で結果は変わる。
今回の比較対象は、Gemma 4 E2B、Gemma 4 E4B、Qwen3.5 4B、Qwen3 8B、Ministral 3 8B、Gemma 4 12B、Ministral 3 14B、gpt-oss-20bの8モデルとした。
いずれも2026年6月時点で公式配布が確認でき、OllamaまたはLM Studioで扱える量子化版が提供されている。
大容量GPUを前提とするモデルや、一般PCではモデルファイルを載せるだけで厳しい大型モデルは主役から外している。
先に全体像を示す。
Gemma 4 E2Bは、Google DeepMindによるGemma 4の小型モデルだ。テキストに加えて画像と音声入力を扱い、最大128Kのコンテキストに対応する。
名称の「E2B」は、ファイル全体が2Bパラメータという意味ではない。
Googleの仕様では実効パラメータが約2.3B、埋め込み層を含む総パラメータは約5.1Bだ。
OllamaのE2B標準タグは約7.2GBで、従来の2Bクラスを想像すると重く感じる。
それでも、画像や音声を含むGemma 4の機能を比較的軽い環境で試せる点は魅力だ。
短い文章の分類、簡単な要約、画像の概要説明、音声内容の確認、ローカル環境の試運転に向く。
複雑な推論、長いコード、精密な日本語記事では、小型モデルらしい限界が出やすい。
CPUだけでも起動候補になるが、生成速度はPC性能に左右される。
16GBメモリでは、コンテキストを短めに設定し、他の重いアプリを閉じた方が安定しやすい。32GBなら余裕を持って試せる。
LM StudioとOllamaの双方で扱える。商用利用を含め、Apache 2.0ではなくGemma 4独自ライセンスの確認が必要になる。
向いている人: 小型のマルチモーダルモデルを試したい人、画像や音声を端末内で扱いたい人
苦手なこと: 高度な推論、長い専門文書、複雑なコード、大量の背景知識を要する質問
初心者へのおすすめ度: 4/5。ただし、名称から想像するほど極端には軽くない
Gemma 4 E4Bは、E2Bより文章、推論、画像理解を強化したモデルだ。実効パラメータは約4.5Bだが、総パラメータは約8B。Ollamaの標準モデルは約9.6GBとなる。
この違いは、モデル選びで見落としやすい。
一般的な4Bモデルなら4bit版が3GB前後に収まることが多いが、E4Bはそれより大きい。
16GBメモリのPCでも動作候補にはなるものの、OS、LM Studio、KVキャッシュを合わせると余裕は少ない。
大きな画像や長い会話を扱えば、スワップが発生して速度が落ちる可能性がある。
32GB環境では、Gemma 4の画像・音声・推論機能を無理なく試しやすい。
日本語は対応言語の一つで、短い会話や要約、画像の読み取りには利用できる。
一方、日本語テキストだけを軽快に扱う目的なら、Qwen3.5 4BやQwen3 8Bの方が負荷と性能の釣り合いを取りやすい場合がある。
向いている人: 画像・音声理解と文章能力を一つの小型モデルで使いたい人
苦手なこと: 16GB環境での長文処理、高速な大量生成
初心者へのおすすめ度: 3.5/5。32GB環境では評価が上がる
Qwen3.5 4Bは、Qwenが2026年に公開した4Bモデルだ。
テキストと画像を同じ基盤で扱い、公式モデルカードでは201の言語・方言を対象とする広い多言語対応が示されている。
4B版は、Qwen3.5シリーズの効率化技術を取り入れつつ、一般PCへ載せやすい規模に収まる。
公式コンテキスト長は262,144トークンだが、16GBのPCで最大値を設定するのは現実的ではない。
まず8Kから16K程度で始め、用途に合わせて増やした方が安定する。
日本語の指示理解、短文から中程度の文章作成、要約、画像説明、簡単なコード、情報の分類に使いやすい。
4Bという規模を考えれば幅広いが、長い論理推論や専門的な事実確認では、8B以上のモデルとの差が出る。
16GB環境の最初の一台として選びやすく、CPUのみでも試せる。Apple Siliconではユニファイドメモリを使って比較的扱いやすい。
NVIDIA GPUなら、VRAM 6GBから8GB程度でも量子化版を載せやすい。
Ollama公式ライブラリとLM Studioのモデルカタログの双方で提供され、Apache 2.0ライセンスで扱いやすい。
向いている人: 一般PCで日本語、画像、要約、チャットを一通り試したい人
苦手なこと: 複雑な長時間推論、大規模コードベース、精密な専門判断
初心者へのおすすめ度: 5/5
Qwen3 8Bは、Qwen3シリーズのdenseモデルだ。
画像入力を持たないテキストモデルで、最大128Kコンテキスト、思考モードと非思考モードを使い分けられる。
最新世代のQwen3.5が登場した後も、ローカル実行環境の対応が成熟し、量子化版を見つけやすい点が強みになる。
日本語の文章作成、要約、分類、アイデア整理、簡単な推論、コード補助を一つのモデルでこなしたい場合、8Bクラスは現在も扱いやすい。
4Bより文章の一貫性や指示追従が安定しやすく、14Bほど重くない。
16GBメモリでは、4bit版と短めのコンテキストなら現実的だ。
PCのメモリをすべて使い切るほどではないものの、ブラウザのタブや画像編集ソフトを同時に大量起動すると速度へ影響する。
GPUなしでも動くが、CPUのみのWindowsノートでは長い回答を待つ場面が増える。
VRAM 8GB前後のNVIDIA GPU、または16GB以上のApple Silicon Macなら体験が改善しやすい。
画像理解が不要で、日本語テキストを中心に使うなら、今回の8モデルの中でも堅実な候補だ。
向いている人: 日本語文章、要約、チャット、コードをバランスよく使いたい人
苦手なこと: 画像やPDFページの視覚理解、最新情報の検索
初心者へのおすすめ度: 4.5/5
Ministral 3 8Bは、Mistral AIがローカルやエッジ環境向けに公開したdenseモデルだ。
Mistral 3の小型シリーズは3B、8B、14Bで構成され、Apache 2.0で提供されている。
テキストだけでなく画像入力へ対応し、公式のコンテキスト上限は256K。
ツール利用や構造化出力を含むアプリへの組み込みも想定されている。
8B版は、Qwen3 8Bと同じく16GBから32GB環境の中心候補になる。
Qwen3 8Bが日本語テキストと推論の成熟度を取りやすいのに対し、Ministral 3 8Bは画像、ツール利用、長い文脈を含む汎用性に強みがある。
ただし、256Kの文脈を一般PCでそのまま使うものではない。
長い資料を扱う際も、RAGで必要箇所を絞るか、コンテキスト上限を現実的な範囲へ下げたい。
日本語は実用になるものの、文体の細かな自然さや長文記事では、同規模のQwenが合う場面もある。
実際の業務文書を両方へ入力し、比較して決めるのが確実だ。
向いている人: 画像、ツール利用、ローカルAPIを含む幅広い用途へ使いたい人
苦手なこと: 16GB環境での極端な長文、クラウド上位モデル級の推論
初心者へのおすすめ度: 4.5/5
Gemma 4 12Bは、12Bのdenseモデルだ。
テキスト、画像、音声入力へ対応し、Gemma 4 Eシリーズより高い文章能力と推論性能を狙える。
4bit量子化版は一般PCでも保存・実行できる範囲に入るが、16GB環境で余裕があるとは言いにくい。
モデル本体を読み込めても、長い会話や画像入力でOSのメモリを圧迫しやすい。
32GBのApple Silicon Mac、またはVRAM 12GB以上と十分なシステムRAMを持つWindows PCでは、現実的な候補になる。
GPUへモデル全体を載せられない場合も、CPUとRAMへ一部を逃がして実行できるが、速度は落ちる。
文章作成、資料の画像理解、図表の説明、音声翻訳、推論を一つのモデルへまとめたい人に向く。
テキストだけを大量処理するなら、同じPCでより軽いQwen3 8Bを高速に回す選択も考えたい。
Gemma 4独自ライセンスのため、商用サービス、派生モデル、再配布へ使う際は、Apache 2.0のモデルと同じ感覚で扱わない方がよい。
向いている人: 32GB以上のPCで文章、画像、音声をまとめて扱いたい人
苦手なこと: 16GB環境、高速な大量バッチ処理
初心者へのおすすめ度: 3.5/5
Ministral 3 14Bは、Mistral 3小型シリーズで最大のdenseモデルだ。
Mistral AIは、従来の24Bクラスに近い性能を、ローカルで扱いやすい14B規模にまとめたモデルとして位置付けている。
文章、画像、コード、ツール利用、長文処理へ対応し、Apache 2.0で商用利用の条件を把握しやすい。
14Bの4bit版は、32GBメモリで使うのが現実的だ。
16GBでも設定次第で読み込める場合はあるが、OSやKVキャッシュの余裕が少なく、実用速度と安定性を考えると積極的には勧めにくい。
VRAM 16GB前後のNVIDIA GPUへ大部分を載せられる環境、または32GB以上のApple Silicon Macと相性がよい。
CPUのみでも動かせる可能性はあるが、回答速度を重視する用途では待ち時間が長くなる。
8Bモデルで文章の精度や推論が物足りなくなり、24B以上へ進むほどの負荷は避けたい人に合う。
向いている人: 32GB以上の環境で、画像を含む汎用性能を上げたい人
苦手なこと: 軽量ノートPC、CPUのみでの高速生成
初心者へのおすすめ度: 3.5/5
gpt-oss-20bは、OpenAIが公開したオープンウェイトの推論モデルだ。
総パラメータ数は約21Bだが、32個の専門家のうち各トークンで4つを使うMoE構造を採用し、稼働パラメータは約3.6Bに抑えられている。
ここで注意したいのは、稼働パラメータが3.6Bだから、4Bモデルと同じメモリで動くわけではないことだ。
計算時には一部の専門家だけを使うが、選ばれる可能性がある全専門家の重みを保持しなければならない。
OllamaのMXFP4版は約14GB。公式には16GBメモリ環境でも動作候補とされているが、16GBのPCではOSとアプリを含めた余裕が非常に小さい。
Apple Siliconの16GBユニファイドメモリでは、動作してもスワップや速度低下が起きる可能性がある。
WindowsではVRAM 16GB級、または十分なRAMを使ったCPU・GPU分割が望ましい。32GBメモリなら扱いやすさが大きく改善する。
強みは、数学的推論、コード、ツール呼び出し、エージェント用途だ。推論負荷を低・中・高から調整できるため、速度と精度を使い分けられる。
一方、OpenAIは学習データを主に英語のテキストと説明している。
日本語でも対話はできるが、日本語文章の自然さを最優先するモデルとは言いにくい。
画像入力にも対応しない。
向いている人: 32GB環境で推論、コード、ツール利用を重視する人
苦手なこと: 日本語の繊細な文体、画像理解、16GB環境での軽快な利用
初心者へのおすすめ度: 3/5
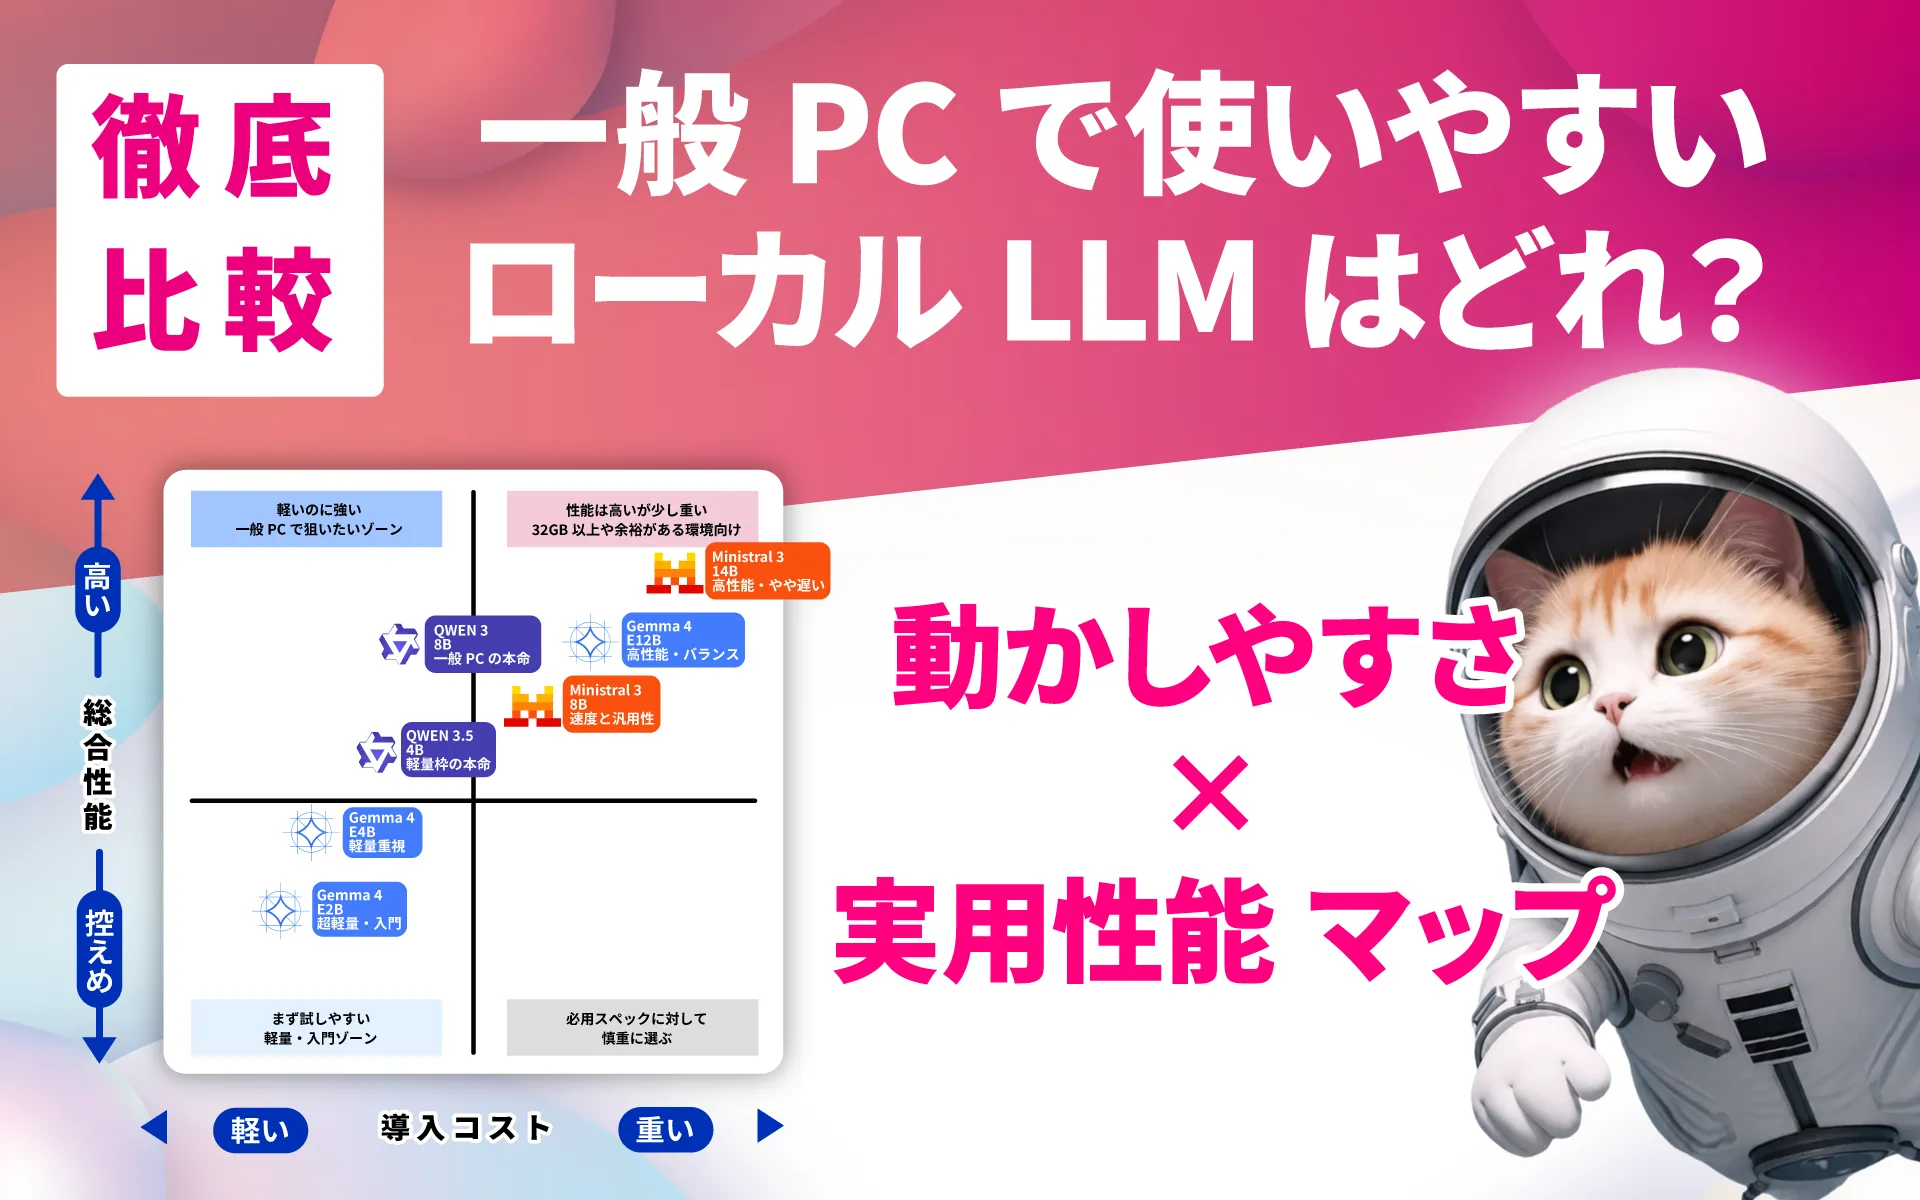
次のマップは、公式ベンチマークをそのまま順位化したものではない。
日本語、指示追従、推論、画像理解、量子化後の容量、メモリ負荷、LM Studio・Ollamaでの導入を総合した編集上の実用目安である。
PC、量子化、プロンプト、用途によって位置は変わる。
8GBメモリのPCでは、OSやブラウザだけでも多くの領域を使う。
Gemma 4 E2BのOllama標準版は約7.2GBあるため、モデル名に「E2B」と付いていても8GB環境で余裕を持って使うのは難しい。
より小さな量子化、Qwen3.5 2B以下、Gemma 3 1Bなどを試す選択はあるが、回答品質も下がる。
ローカルLLMを体験する目的なら、小型モデルを短いコンテキストで動かしてよい。
一方、仕事で安定した文章や推論を求めるなら、ChatGPT、Claude、GeminiなどのクラウドAIを使う方が現実的だ。
8GB環境で無理に大きなモデルを動かすと、ストレージを仮想メモリとして使い、PC全体が極端に遅くなる可能性がある。
16GB環境では、選択肢が大きく広がる。
最初に試すならQwen3.5 4B。日本語、画像、一般的なチャットを一つのモデルで試しやすい。
テキスト中心で文章や推論を少し強化したいならQwen3 8Bが候補になる。
Ministral 3 8Bも実用圏に入る。画像やツール利用を重視するなら有力だ。
Gemma 4 E2Bは利用できるものの、Ollama標準版が約7.2GBあるため、Qwen3.5 4Bより必ず軽いとは限らない。
E4Bは約9.6GBあり、16GBでは設定を抑えて使うモデルになる。
gpt-oss-20bは公式上16GBメモリでも動作候補だが、約14GBのモデル本体にOSとKVキャッシュが加わる。
起動できることと快適に使えることを分けて考えたい。16GB環境で最初に選ぶモデルではない。
32GBあれば、Qwen3 8BとMinistral 3 8Bを余裕を持って動かしながら、Gemma 4 12B、Ministral 3 14B、gpt-oss-20bも検討できる。
画像と音声を含む一体型のモデルが欲しければGemma 4 12B。文章、画像、コード、ツール利用を幅広く扱うならMinistral 3 14B。
推論とコードを重視するならgpt-oss-20bという分け方になる。
32GBでも、公式最大コンテキストをそのまま使えるとは限らない。
長い文書を何十万トークンも直接投入するより、RAGで必要箇所を検索し、8Kから32K程度へ絞る方が速度と精度を両立しやすい。
64GB以上のApple Silicon Macや大容量RAM搭載PCでは、20Bから30B級、MoEモデルの一部まで試せる。
ただし、モデルを大きくすれば、常に日常業務の成果が比例して良くなるわけではない。
簡単な要約を大量に処理するなら、8Bを高速に回す方が効率的だ。モデルの切り替え、保存容量、起動時間も増える。
一般PC向けの範囲では、まず8Bから14Bを基準にし、不足が明確になってから大型モデルへ進む方がよい。
Apple Silicon Macは、CPUとGPUが同じユニファイドメモリを共有する。
一般的なWindows PCでは、システムRAMが32GBあってもGPUのVRAMが8GBなら、GPUだけに載せられるモデルは限られる。
Macでは32GBのユニファイドメモリをGPU処理にも使えるため、12B、14B、gpt-oss-20bなどを一つのメモリ空間へ載せやすい。
LM StudioはApple Siliconに対応し、MLX形式のモデルも利用できる。
MLXはApple Silicon向けに最適化された機械学習基盤で、対応モデルでは効率のよい実行が期待できる。
ただし、ユニファイドメモリの全容量をモデルへ使えるわけではない。
macOSと他のアプリにも領域が必要だ。
16GB Macなら4Bから8B、32GBなら8Bから20B前後を中心に考えると現実的だ。
長時間の推論では本体が熱くなり、MacBookではバッテリー消費も増える。
Windows PCでは、システムRAMとNVIDIA GPUのVRAMを混同しないことが大切だ。
RAMが32GBでも、VRAM 6GBのGPUへ14Bモデル全体を載せることはできない。
LM StudioやOllamaは、入りきらない層をRAMとCPUへ分けるCPUオフロードに対応するが、すべてをGPUへ載せた場合より速度は落ちる。
目安として、VRAM 6GBから8GBなら4Bから8Bの量子化モデル。
VRAM 12GBなら8Bから14Bの一部。VRAM 16GBなら14Bやgpt-oss-20bが候補に入りやすい。
CPUのみでも実行は可能だが、CPUの世代、メモリ帯域、モデルサイズによって速度差が大きい。
短い要約や分類なら待てても、長文生成や高い推論負荷では実用性が下がる。
普通のチャットと日本語文章作成には、Qwen3 8Bが安定候補になる。軽さを優先するならQwen3.5 4B。
画像も読みたい場合はQwen3.5 4BまたはMinistral 3 8Bを選びやすい。
要約や社内文書検索では、モデルサイズだけでなくRAGの検索精度が結果を左右する。
8Bモデルと適切な埋め込みモデルを組み合わせれば、大きなモデルへ全文を投入するより効率よくなる場合がある。
推論とコードではgpt-oss-20bが有力だが、PC負荷と日本語文体には注意が必要だ。
32GB未満なら、Qwen3 8Bの思考モードから試す方が導入しやすい。
PDFの確認は、PDFがテキストとして抽出できるか、ページ画像を読む必要があるかで変わる。
文字PDFの要約ならQwen3 8Bでもよい。
図表やスキャン文書を視覚的に読むなら、Qwen3.5、Gemma 4、Ministral 3などの画像対応モデルが必要になる。
モデルの利用料がゼロでも、PCを新しく買えば初期費用が発生する。
すでに十分な性能のPCを所有し、毎日大量の文章やファイルを処理する人は、ローカルLLMの費用対効果を得やすい。
APIの呼び出し回数を気にせず、試行錯誤や自動処理を繰り返せるためだ。
一方、月に数回質問するだけなら、クラウドAIの無料枠や月額プランの方が安く、設定時間もかからない。
専用GPUを買う場合も慎重に考えたい。
GPUだけで10万円以上を使い、電源や冷却まで増強するなら、費用を回収するには相当な利用量が必要になる。
ストレージも積み上がる。
4bitモデル一つなら数GBから十数GBだが、量子化方式を比較し、複数世代を保存すると100GBを超えることもある。
セキュリティやデータ管理には、金額だけでは測れない価値がある。
社外へ出せない資料を端末内で処理できるなら、クラウド料金との単純比較では見えない便益が生まれる。
LM Studioは、モデル検索、ダウンロード、チャット、設定をGUIで進められるローカルAIアプリだ。
モデルカタログからQwen、Gemma、Ministral、gpt-ossなどを探し、GGUFやMLX形式をダウンロードできる。
量子化の違い、ファイル容量、想定メモリを画面で確認しやすい。
ダウンロード後は、チャット画面ですぐに質問できる。
プログラムから接続したい場合は、OpenAI互換のローカルAPIサーバーとしても利用可能だ。
最初の一台を試す人には、次の流れが分かりやすい。
同じモデルでも複数の配布者や量子化が表示される。公式モデルから作られたものか、配布元の実績があるかを確認したい。
Ollamaは、コマンドからモデルを取得・実行し、ローカルAPIとして利用できる環境だ。
たとえば、対応モデルなら次のように実行できる。
ollama run qwen3.5:4bollama run qwen3:8bollama run gemma4:e2bollama run gpt-oss:20b
モデル名だけで必要なファイルとチャット形式を取得できるため、手動でGGUFを選び、テンプレートを設定する負担が少ない。
コマンド操作が中心だが、APIからPython、業務ツール、RAG、Open WebUIなどへ接続しやすい。
ローカルAIをチャット以外の仕組みへ組み込みたい人に向く。
OllamaにもデスクトップアプリやGUI機能が加わっているが、モデル管理と外部連携を細かく扱うなら、コマンドとAPIの基本を知っておくと便利だ。
量子化とは、モデルの数値精度を下げ、ファイル容量と必要メモリを減らす方法だ。
一般PCでは、Q4_K_Mなど4bit前後が、品質と軽さの折衷として使いやすい。
さらに小さなQ2やQ3は軽くなる一方、回答品質が落ちやすい。Q6、Q8、FP16へ上げるほど品質維持を期待できるが、必要メモリも増える。
初めて使う際に、公式の最大コンテキストを設定する必要はない。
128K対応モデルでも、通常のチャットや短い資料なら8Kや16Kで足りる。
必要以上に広げるとKVキャッシュが増え、モデル本体より会話履歴の保持が負担になる。
まず軽い設定で速度を確認し、実際に長い資料が必要になってから広げる方がよい。
第一の利点は、データの処理経路を自分で管理しやすいことだ。
顧客の個人情報を匿名化して分類する。
社内規程を検索するRAGを作る。
公開前の原稿や契約資料を要約する。
こうした作業を、外部APIへ直接送らずに構築できる。
オフライン利用も価値がある。
通信が制限された現場、移動中、閉域ネットワーク内でも、モデルと必要なソフトウェアを保存していれば処理を継続できる。
API利用料を気にせず、同じタスクを何度も試せることも強みだ。
数千件の定型文分類、プロンプト比較、RAGの検索評価、アプリ開発のテストでは、呼び出し回数が多いほどローカル実行の利点が出やすい。
モデルを用途ごとに切り替えられる点も見逃せない。
普段の分類には4B、文章作成には8B、複雑な推論にはgpt-oss-20bというように、同じ環境で使い分けられる。
プロンプト、検索データ、ログを自分の管理下へ置き、長期的に自分専用のAI環境を育てることも可能だ。
ローカルLLMは、クラウドAIの全面的な代替ではない。
最新ニュースや現在の料金を調べる場合、検索機能とWebアクセスを持つクラウドAIの方が早い。
ローカルモデルだけでは、学習時点より後の情報を自動で取得できない。
高度な推論、長いコードベース、精密な画像・音声・動画処理でも、クラウドの上位モデルが有利なことが多い。
大規模な計算環境をユーザー側で準備せず、常に更新されたモデルを使えるためだ。
PC性能が低い人、複数端末から同じ環境へアクセスしたい人、チームで安定した管理機能を使いたい人にもクラウドが向く。
月に数回しか使わないなら、モデルのダウンロード、更新、ストレージ、電気代へ時間と費用をかける意味は小さい。
現実的には、機密資料や大量処理をローカル、最新情報と高度な判断をクラウドへ分ける方法が使いやすい。
導入時には、モデル形式、量子化、チャットテンプレート、コンテキスト、GPUオフロードなどを理解する必要がある。
LM StudioやOllamaで簡単になったとはいえ、クラウドAIのアカウントを作るだけの体験とは異なる。
PC性能が上限になるため、モデルを大きくすると生成速度が落ちる。
CPUだけで14Bや20Bを動かせても、長い回答に数分待つなら、日常業務では使わなくなる可能性がある。
ストレージ消費、発熱、ファンの音、バッテリー消費も増える。
長時間のバッチ処理では電気代もかかる。
モデルの追加、削除、更新、脆弱性対応、アクセス権限は自分で管理しなければならない。
RAGへ機密資料を登録する場合、ベクトルデータベースやログにも内容が残る。
誤回答やハルシネーションは、ローカルでも起きる。
外部へ送信していないことと、回答が正しいことは無関係だ。
ライセンスもモデルごとに異なる。Qwen、Ministral 3、gpt-ossはApache 2.0だが、Gemma 4には専用ライセンスと利用制限がある。
社内利用、顧客向けサービス、再配布、派生モデルでは、最新版の条文を確認する必要がある。
大きなモデルは、起動、速度、メモリ、ストレージの負担も増える。
日常的な要約や分類なら、小型モデルを速く回す方が役立つ。
RAMはPC全体が使うメモリ、VRAMは主にGPUが使う専用メモリだ。
Windowsでは両方を確認する。
同じモデル名でも、Q2、Q4、Q8、FP16では容量と品質が異なる。
一般PCでは4bit前後から始めやすい。
長い文脈はKVキャッシュを増やす。
必要な分だけ設定し、長文はRAGや分割処理も検討する。
多言語対応と、日本語の自然な文章作成は同じではない。
自分の資料と指示で比較する。
学習データ、調整、アーキテクチャ、量子化、推論モードによって結果は変わる。
MoEは一部の専門家だけを動かして計算量を減らすが、全モデルの重みを保存する必要がある。
モデルがメモリを使い切ると、ブラウザ、会議アプリ、文書ソフトまで遅くなる。
複数の量子化やモデルを保存すると、数十GBから数百GBを使う。
モデルの利用、改変、再配布、ホスティングには、モデルごとの条件がある。
処理場所が変わっても、モデルの知識不足や推測は残る。
重要情報は元資料で検証する。
ディスク暗号化、OS更新、アクセス制御、バックアップ、外部連携の管理が必要になる。
Fable 5の停止とGPT-5.6の限定公開は、AIモデルの性能だけを比較していればよかった時代が終わりつつあることを示した。
クラウドAIでは、利用者がモデルを所有しているわけではない。
毎月料金を払い、業務へ組み込み、使い方を習得していても、提供地域、政府規制、安全方針、企業戦略が変われば、アクセスできるモデルは入れ替わる。
最新モデルが発表されても、自分が使えるとは限らない。
今回の規制が一時的な例外で終わる可能性もある。
しかし、サイバーセキュリティ、軍事転用、輸出管理を理由とした審査が強まれば、高性能AIへのアクセスが段階的に管理される場面は増えるかもしれない。
そのとき、ローカルLLMを持つ意味は「API料金を節約する」だけではなくなる。
一度取得したモデルを手元で保持し、外部サービスの都合に左右されずに使い続ける。
機密資料を端末内で処理し、オフライン環境でも動かす。クラウド側のモデルが停止した場合にも、文章作成、要約、分類、社内検索といった基本業務を継続する。
ローカルLLMは、AI環境の予備回線に近い存在になり得る。
ただし、規制への不安だけを理由に、無理に大型モデルを導入する必要はない。
16GBのPCであれば、Qwen3.5 4Bから始めるのが現実的だ。
日本語、画像、一般的なチャットを比較的軽い環境で試せる。
テキスト中心の文章作成や要約を重視するなら、Qwen3 8Bが一般PCの本命になる。
画像理解や外部ツールとの連携も使いたい場合は、Ministral 3 8Bを比較したい。32GB以上のPCなら、Gemma 4 12B、Ministral 3 14B、gpt-oss-20bまで選択肢が広がる。
推論やコードを優先するならgpt-oss-20bが候補になるものの、MoEだから4Bモデル並みに軽いわけではない。
モデル全体の重みを保持する必要があり、16GBでは余裕が少ない。快適さを求めるなら32GB以上で考える方がよい。
一方、PCが8GBしかない、AIを月に数回しか使わない、最新情報の検索や高度な推論を重視する、モデルの更新を自分で管理したくないという人には、今後もクラウドAIが適している。
選択肢は、クラウドかローカルかの二者択一ではない。
通常の業務にはChatGPT、Claude、Geminiを使い、外部へ出せない資料や大量の定型処理はローカルへ回す。
クラウドで使っているモデルが停止した際に備え、手元には4Bまたは8Bモデルを置いておく。性能が必要な作業だけクラウドへ戻す。
こうした分散した使い方の方が、現在のAI環境には合っている。
高性能なモデルへいつでもアクセスできることは、以前ほど当然ではなくなった。
サービス提供者、政府、地域、契約によって、使えるAIが変わる可能性を考えなければならない。
だからこそ、最初から大規模な環境を作る必要はなくても、ローカルLLMを一度動かし、自分のPCでどこまでできるかを知っておく価値はある。
まず4Bまたは8Bのモデルをダウンロードし、短い文章、要約、資料検索から試してみる。
クラウドAIとの差を確認し、自分の仕事で代替できる部分と、代替できない部分を見極める。
ローカルLLMは、クラウドAIから逃げるための道具ではない。
利用条件が変わっても、自分のAI環境をすべて失わないための選択肢である。