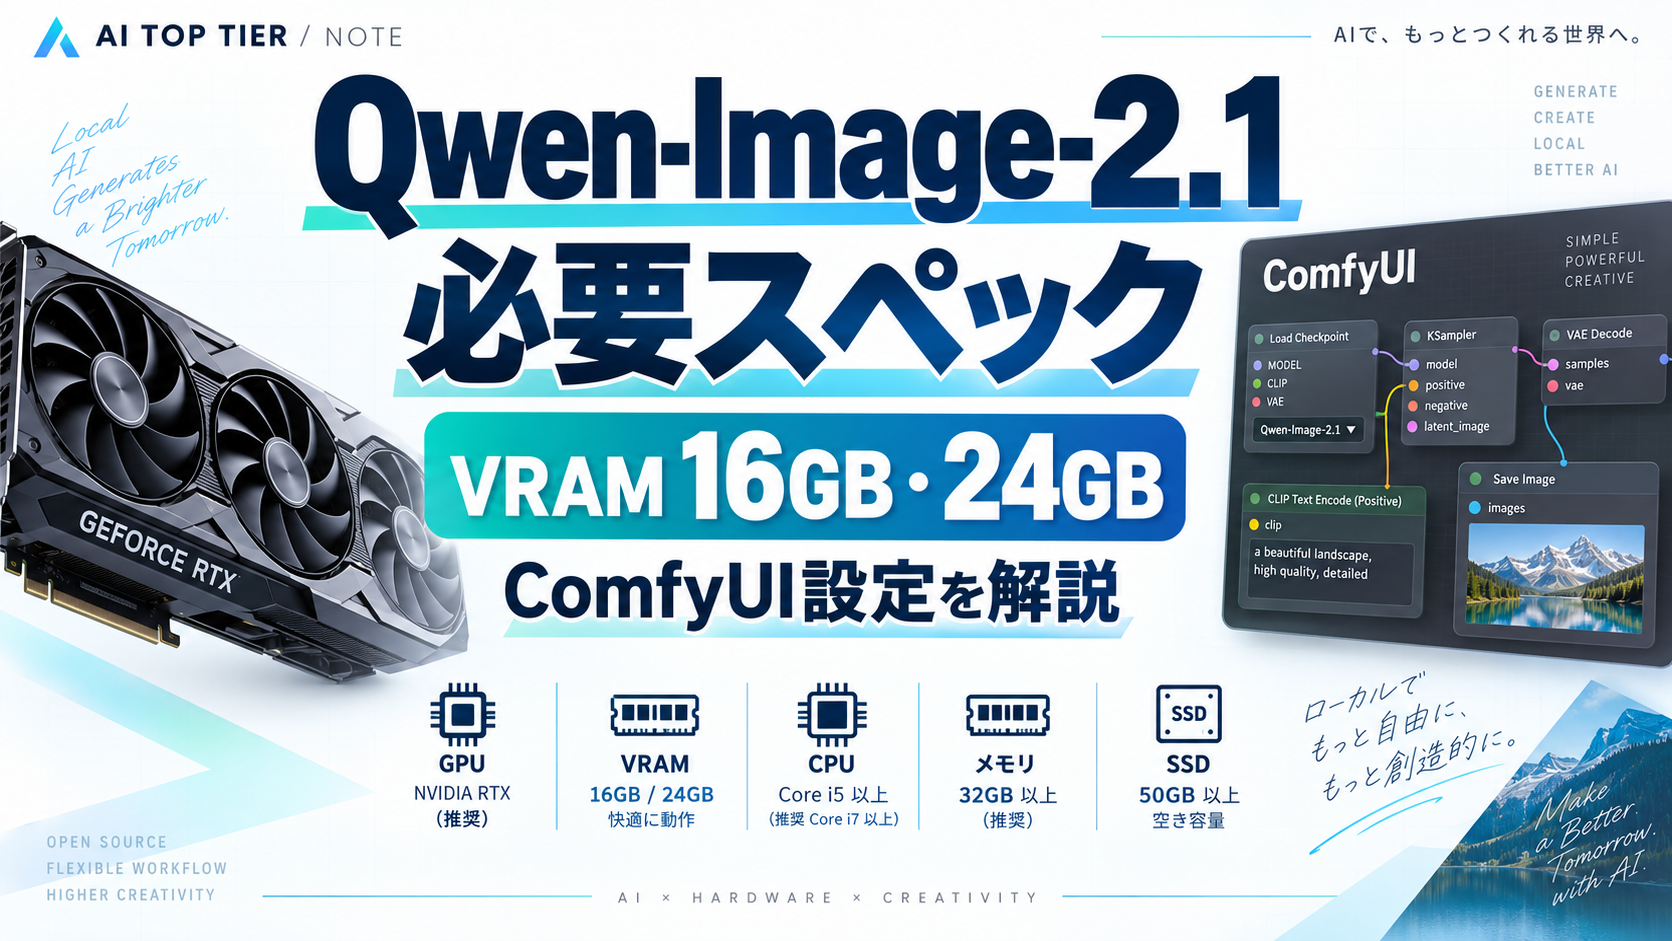


Qwen-Image-2.1は「7Bの画像生成モデル」と紹介されることがあります。
数字だけを見ると、VRAM 16GBのGPUでも余裕で動きそうに見えるかもしれません。
しかしローカル運用では、画像生成本体だけでなく、プロンプトや参照画像を処理するテキスト/ビジョンエンコーダ、VAE、生成中の中間データまでメモリを使います。
そのため、必要スペックを考えるときは「モデルファイルがVRAMに収まるか」だけでは不十分です。
1024pxで1枚生成するのか、2Kにするのか。参照画像を何枚使うのか。BF16を維持するのか、INT8やGGUFで軽量化するのか。
CPUオフロードを使うなら、今度はシステムRAMと転送速度がボトルネックになります。
この記事では、公式に確認できるモデル構成とファイル容量を土台にし、16GB・24GB・32GBのGPUで何が現実的かを分けて整理します。
公式が固定の「最低VRAM」を示しているわけではないため、VRAM別の目安は事実と編集上の推定を分けて記載します。
Qwen-Image-2.1は、テキストからの画像生成と画像編集を統合したモデルです。
公式モデルカードでは、画像生成コンポーネントは7Bパラメータ、32層のSingle-Stream DiTで構成されています。
通常画像だけでなくRGBAの透明画像にも対応し、最大10枚の参照画像を扱える点も特徴です。
ローカル実行で重要なのは、7Bという数字だけを見ないことです。
Hugging Faceの公式Diffusers構成では、Transformerが約14.2GB、テキストエンコーダが約17.5GB、VAEが約1.35GBあります。
これだけで主要ファイルは約33GBです。
ComfyUI向けの単一ファイル構成ではVAEが約676MBのものもありますが、BF16の画像生成モデル14.2GBとテキストエンコーダ17.5GBが大きな割合を占める点は変わりません。
つまり「BF16モデルが14GBだから16GB VRAMで余裕」という理解は誤りです。
実際のワークフローでは、各コンポーネントを必要なタイミングでGPUとCPUの間に移すことで、VRAMを節約できます。
Qwen公式もメモリが限られたGPU向けにmodel CPU offloadを案内しています。
まず、公開されている主要ファイルと位置づけを整理します。
BF16は公式実装で基準になる精度です。
画質検証や再現性を重視しやすい一方、ファイル容量とVRAM要求は最も大きくなります。
32GB級GPUでも、主要ウェイトをすべてGPUへ置けば実行時の余裕がほぼ残らないため、完全常駐を前提にするなら32GBを「十分」とは言い切れません。
ComfyUIの公式ワークフローでは、画像生成TransformerにBF16 14.2GBとINT8 ConvRot 7.26GB、テキストエンコーダにもBF16とINT8 ConvRotの選択肢が案内されています。
INT8は大幅に軽くできますが量子化は不可逆です。画質差はプロンプト、編集内容、参照画像の使い方で出方が変わるため、「INT8なら必ず同じ画質」とは扱わないほうが安全です。
FP8は、Qwen公式がvLLM-Omniでの高速推論機能としてサポートを案内しています。
ただし、ComfyUIの公式単一ファイル構成で案内されているINT8 ConvRotと同じものではありません。
ComfyUIでFP8を使いたい場合は、その時点で対応するローダーや変換済みウェイト、実装の成熟度を個別に確認する必要があります。
GGUFはさらに低ビット化しやすく、コミュニティではQ8_0、Q6_K、Q5_K_M、Q4_K_Mなどの配布例があります。
たとえばQ4_K_Mの画像生成モデルは約4.6GBという例があります。
ただしQwen公式やComfy-Orgの標準配布とは別物です。
配布元、変換方法、対応ノード、破損や安全性、画質差を確認したうえで使うべき選択肢です。
公式は「最低VRAM 16GB」のような固定値を出していません。
そこで以下は、公式ファイル容量、CPUオフロードの仕組み、公開されている実測例から整理した編集上の目安です。
解像度、バッチ数、参照画像数、ノード構成で結果は変わります。
16GBについては、RTX 5060 Ti 16GBでComfyUI、INT8 ConvRot、1024×1024、25 stepsを使い、ピークVRAM約15.8GBで動作したコミュニティ実測があります。
これは「16GBでも動く」根拠にはなりますが、余裕が約3%しかない条件でもあります。
別のカスタムノードを追加したり、参照画像や解像度を増やしたりすれば、そのまま再現できる保証はありません。
24GBでは、16GBほど厳密にVRAMを詰めなくても運用しやすくなります。
RTX 4090のような24GB GPUなら、量子化されたTransformerとエンコーダを使いつつ、VAEや一部処理をGPUへ残すなど、速度とメモリのバランスを取りやすくなります。
ただし「24GBならBF16を全部ロードできる」という意味ではありません。
32GBは量子化構成ならかなり扱いやすく、2K生成や複数参照画像を試す余地が増えます。
それでもBF16主要ウェイトの合計だけで32GBを超えるため、GPUメモリだけで全コンポーネントを常駐させる前提にはしないほうが安全です。
ComfyUIはQwen-Image-2.1をリリース時点からネイティブ対応しています。
公式ワークフローには、テキスト生成用と画像編集用のテンプレートが用意され、必要ファイルの配置先も示されています。
基本構成では、diffusion_modelsにQwen-Image-2.1の生成モデル、text_encodersにQwen3-VL系エンコーダ、vaeに専用VAEを置きます。
BF16を使うかINT8を使うかでダウンロード容量と必要メモリが大きく変わるため、最初に自分のVRAMに合わせてファイルを選んだほうが無駄がありません。
16GB環境では、最初から最大解像度や多数の参照画像を狙うより、1024px・バッチ1・参照なし、または参照1枚から始めるほうが切り分けしやすくなります。
動作を確認したら、解像度、参照画像数、ステップ数を一つずつ上げます。
OOMが出たときに複数条件を同時に変えると、原因がわからなくなります。
Diffusersを使う場合、Qwen公式はメモリが限られたGPU向けにenable_model_cpu_offloadを案内しています。
これはVRAM不足を補う有効な方法ですが、CPU側へモデルを逃がすため、システムRAMが少ないPCでは別の問題が出ます。
BF16一式を扱うなら、32GB RAMではOSやComfyUIとの取り合いが起きやすく、64GB以上のほうが現実的です。
16GB VRAM機で重いオフロードを多用するなら、RAM容量だけでなくPCIe転送やCPU性能も生成時間に影響します。
ストレージも見落とせません。
Comfy-Orgのリポジトリ全体は複数精度のファイルを含むため70GBを超えますが、すべてをダウンロードする必要はありません。
BF16の主要3ファイルだけなら約32GB、量子化構成ならさらに減らせます。
モデル更新や別量子化を試すなら、100GB程度の空きを確保しておくと運用しやすいでしょう。
Windows+NVIDIA GPUは、ComfyUIでQwen-Image-2.1を試すうえで最も情報量が多い構成です。
16GBでも量子化を前提に始められますがこれからPCを購入し、2Kや画像編集を日常的に使いたいなら、24GB以上のVRAMは設定の余裕に直結します。
Macについては、QwenのHugging FaceモデルカードにAppleデバイスではMPSへ切り替える例が掲載されています。
したがって「Macでは一切動かない」というモデルではありません。
ただしApple SiliconではGPU専用VRAMではなくユニファイドメモリをCPUと共有します。
必要量はMacの総メモリ、OS、アプリ、推論実装によって変わるため、NVIDIAの16GB/24GBと同じ感覚で比較しないほうがよいでしょう。
購入判断では、最初に「生成できればよい」のか、「2Kを待ち時間少なく回したい」のか、「画像編集で複数参照を常用したい」のかを決めます。
前者なら16GB+量子化でも候補になります。中間なら24GB、長期的に高解像度と編集を重視するなら32GB以上を見たほうが余裕があります。
さらに、Qwen-Image-2.1以外の大型モデルも同じPCで使うなら、VRAMは将来余力として効きます。
GPUを数年使う前提では、今の最低構成に合わせるより、普段のワークフローでオフロードを減らせる容量を選ぶほうが体感速度の改善につながりやすいでしょう。
Qwen-Image-2.1は7Bモデルですが、ローカル実行に必要な構成全体は7Bのイメージより重いモデルです。
BF16ではTransformer、テキストエンコーダ、VAEの主要ウェイトだけで30GBを超え、実行時メモリも別に必要です。
一方で、ComfyUIのINT8 ConvRotやCPUオフロードを使えば、16GB GPUでも現実的に試せる構成があります。
24GBは設定の自由度が高まり、32GBでは量子化構成をかなり扱いやすくなります。
ただし高解像度や複数参照画像ではメモリ負荷が増えるため、「VRAM容量だけ」で可否を決めないことが大切です。
これからGPUを買うなら、起動できる最低ラインではなく、自分が使いたい解像度、参照画像数、生成回数、待ち時間を基準に選ぶのが失敗しにくい方法です。