

「9Bモデルなら16GBメモリのPCで余裕」と考えると、ローカルLLMでは意外なところで詰まる。
ダウンロードしたモデル本体だけでメモリを使うわけではなく、推論時にはKVキャッシュ、ランタイム、OS、場合によっては画像encoderまで同居するからだ。
Xiaomi MiMoが公開したMiMo-V2.6-Distill-Qwen-9Bは、Qwen3.5-9Bをベースにした9Bのエージェントモデルで、コーディング、一般的なエージェント処理、visual coding、cybersecurityを対象としている。
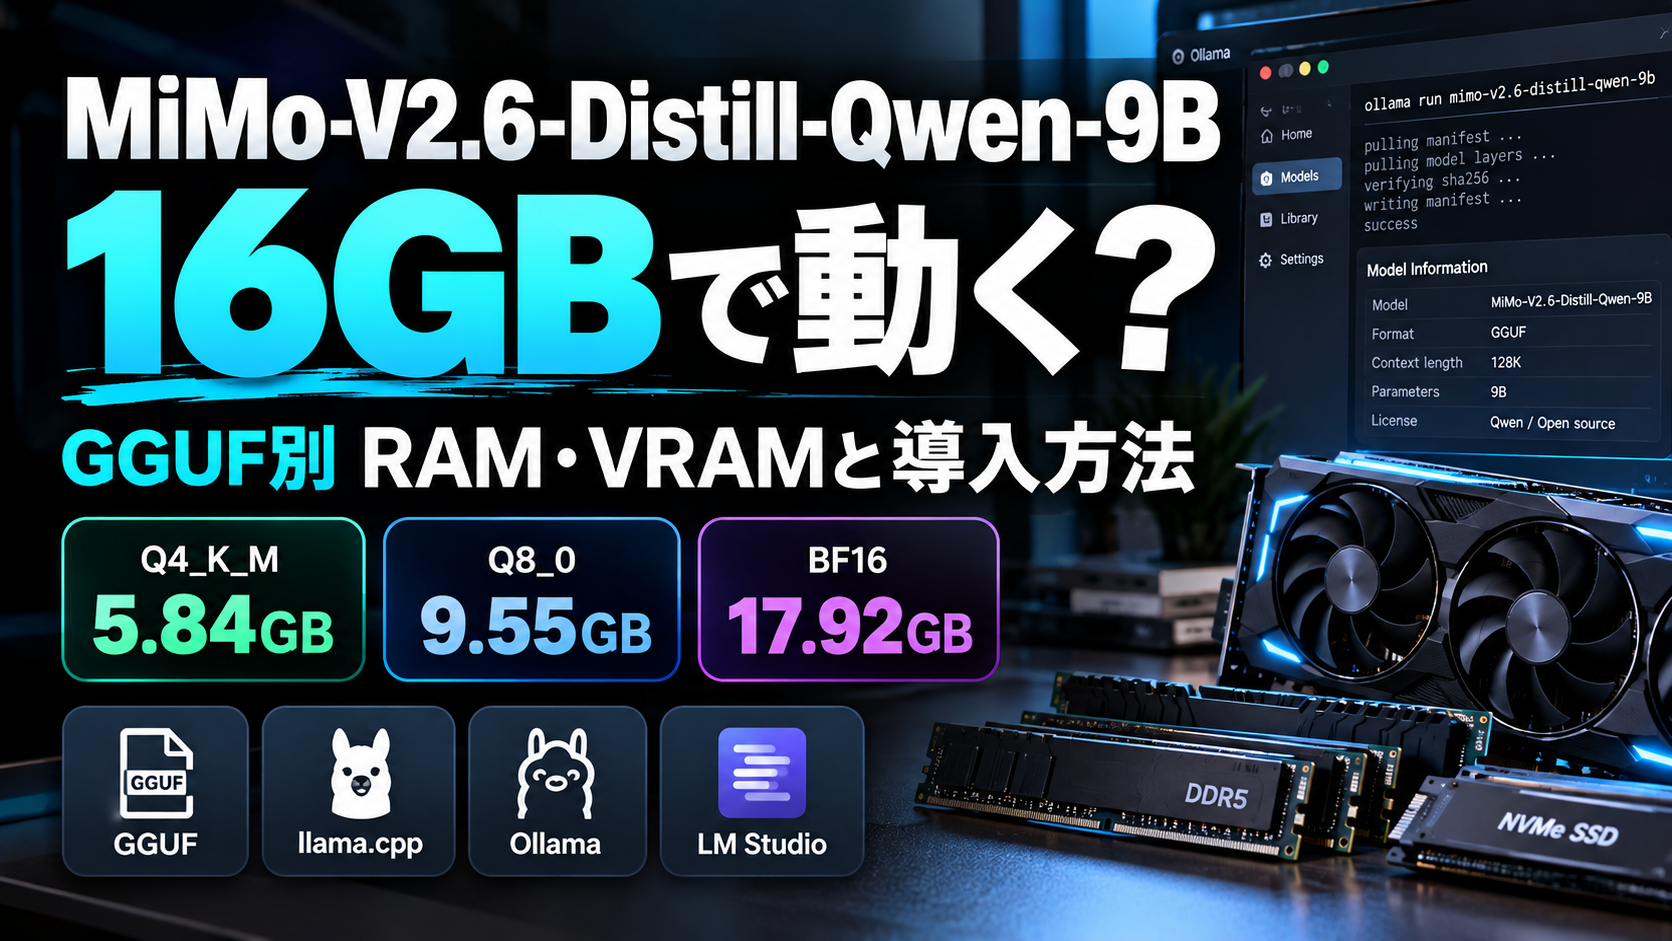
公式配布はSafetensorsで約18.8GB。ggml-orgからはllama.cpp向けのQ8_0 GGUFも公開され、モデル本体は9.53GBまで縮小できる。
では16GB RAM、8GB VRAMの一般的なPCでも使えるのか。答えは「量子化と使い方次第」だ。
本体容量だけではなく、実行時に何GB残せるかを基準に考える必要がある。
公式モデルカードによると、MiMo-V2.6-Distill-Qwen-9BはQwen3.5-9Bをベースに、Xiaomi MiMoが生成したデータで教師あり微調整したモデルだ。
位置付けはagentic modelで、コード生成だけでなくツール利用や一般的なエージェントタスク、画像を含むvisual codingにも対応する。
Xiaomiが公開した評価では、SWE Verified、SWE Pro、MiMo Code、AutomationBench、Terminal Bench、ToolathlonなどでベースのQwen3.5-9Bを上回る結果が示されている。
ただし、これはMiMo側が技術レポートで報告した評価値であり、利用者のPC上で同じ速度や成功率が保証されるわけではない。
公式リポジトリのSafetensorsは4分割で合計約18.8GB。
configではQwen3_5ForConditionalGenerationとして定義され、画像トークンを持つマルチモーダル構成になっている。
ローカル実行ではテキストだけ使うか、画像も使うかで必要メモリが変わる。
モデルの「9B」はパラメータ数であって、必要RAMを直接表す数字ではない。
BF16なら重みだけでも約18GB規模になるため、16GB RAMへそのまま収める前提では考えにくい。
そこでGGUF量子化を使い、1パラメータ当たりのビット数を落として容量を減らす。
ggml-orgの自動変換版ではQ8_0が9.53GB。
さらにコミュニティ量子化ではQ6やQ4が用意され、Q4_K_Mは約5.84GBの例がある。
ただし、5.84GBのファイルを読み込めばRAM使用量も5.84GBで止まるわけではない。
推論中にはモデル重みのほかにKVキャッシュ、計算バッファ、ランタイム、OSと常駐アプリがメモリを使う。
画像を扱う場合はvision encoder用のmmprojも加わる。ggml-orgのQ8_0 mmprojは624MBで、本体とは別ファイルだ。
量子化は容量を小さくするほどメモリに余裕ができる一方、元の重みから情報を削るため品質への影響が大きくなる可能性がある。
9Bクラスでは、16GB RAMならQ4〜Q6、32GB RAMならQ8まで含めて比較しやすい。
ここでQ4_K_MとQ6系の容量は派生GGUFの例であり、Xiaomi公式配布のファイルではない。
配布元、変換元のコミット、チャットテンプレート、vision projectorの有無を確認してから使いたい。
16GB RAMでは、Q4_K_Mから試すのが安全側だ。
モデル本体が約6GBなら、OSやブラウザ、推論バッファ、KVキャッシュに残りを回せる。
テキスト中心で短〜中程度のコンテキストなら、Q6へ上げて品質差を比べる余地もある。
Q8_0は本体だけで9.53GBある。
16GB RAMでも読み込み自体が可能な環境は考えられるが、長いコンテキストや画像入力を併用すると余裕が急速に減る。
スワップが頻発すれば「動く」ことと「快適に使える」ことが別になる。
32GB RAMではQ8_0を含めて選択肢が広がる。
長めのコンテキスト、画像encoder、開発ツールやブラウザを同時に開く使い方でも余白を取りやすい。
ローカルAIを常用するなら、モデル本体が入る最低容量より、作業アプリと同時使用した際の余裕を重視したい。
GPUを使う場合、VRAMへモデルの多くを載せるほど一般に推論を高速化しやすい。
8GB VRAMならQ4系は全量GPU配置を狙いやすいが、実際にはコンテキストや計算バッファ分も必要なので、VRAMをモデルファイルで100%使い切る設計は避ける。
Q6やQ8がVRAMへ収まらない場合、llama.cppでは一部レイヤーをCPU側へ残す構成が取れる。
これにより8GB GPUでも大きな量子化を実行できる可能性がある一方、CPUとGPUをまたぐ処理が増えるため速度は落ちやすい。
12GB VRAMではQ8_0本体9.53GBを載せる余地が見えるが、画像encoderやKVキャッシュまで考えると設定次第だ。
16GB VRAMならさらに余裕が増えるものの、長いコンテキストを使えば追加メモリは増える。
VRAM容量だけから最大コンテキストを決めない方がよい。
ローカルLLMで見落とされやすいのがKVキャッシュだ。
モデルを一度読み込んだ後も、入力したトークンを保持するためのメモリが必要になる。
会話履歴やコードベースを長く渡すほど、その使用量は増える。
したがって、モデルカードに大きなコンテキスト上限が書かれていても、16GB PCでその上限まで快適に使えるとは限らない。
実用上は4K、8K、16Kと段階的に増やし、RAM/VRAM使用量と生成速度を測る方が確実だ。
量子化でモデル本体を小さくしてもKVキャッシュの問題は消えない。
Q4を選ぶ価値は、単にダウンロードを軽くすることではなく、推論時の追加メモリへ余白を残せる点にもある。
現時点で最も根拠が明確なのはllama.cppだ。
ggml-orgのGGUFページには、llama serveコマンドやllama cliから直接起動する例が掲載されている。
WindowsではWinGetからllama.cppを導入する方法も案内されている。
OllamaやLM Studioで使う場合は、アプリの最新バージョンがQwen3.5アーキテクチャと当該GGUFのチャットテンプレート、画像入力に対応しているかを確認したい。
GGUFファイルを読み込めることと、全機能が正しく動くことは同義ではない。
特に公開直後のモデルは、ランタイム側の更新で互換性が改善することがある。
導入記事では「Ollamaなら必ず動く」と固定せず、利用するバージョンでモデル読み込み、テキスト生成、ツール利用、画像入力を順番に検証する。
MiMo-V2.6-Distill-Qwen-9BはImage-Text-to-Textとして公開されている。
ggml-orgのGGUFにはQ8_0のvision encoder用mmprojが含まれ、ファイル容量は624MB。
画像を使う場合はモデル本体だけを見てメモリを見積もらない方がよい。
画像の解像度や処理方法によって推論時の負荷も変わる。
16GB RAM環境でテキスト生成が安定していても、画像入力を追加した途端にスワップやVRAM不足が起きる可能性がある。
visual codingを試したい場合は、まずテキストのみで安定性と速度を測り、その後mmprojを追加して画像1枚から検証する。
この順序なら、問題がモデル本体、vision側、メモリ不足のどこにあるか切り分けやすい。
ggml-orgのGGUFページではライセンスがMITと表示され、元モデルはXiaomiMiMo/MiMo-V2.6-Distill-Qwen-9Bへ紐付けられている。
MITは一般に商用利用を許容するライセンスだが、実際の製品利用では元モデルのライセンス本文と配布物のNOTICE等を確認する必要がある。
コミュニティが再量子化したGGUFを再配布・組み込む場合は、そのリポジトリが正しい元モデルから変換されたか、追加条件がないかも確認したい。
モデルのライセンスと、生成物に含める第三者データ・コード・商標などの権利は別問題である。
企業利用ではモデルの入手元、コミット、量子化方法、依存ライブラリのライセンスを記録しておくと後の監査が楽になる。
MiMo-V2.6-Distill-Qwen-9Bは、9Bという比較的扱いやすい規模でコーディングやエージェント処理、画像入力まで試せるモデルだ。
ただし、16GB PCでの快適さは「9B」という数字だけでは判断できない。
16GB RAMならQ4_K_Mを入口にし、余裕を確認しながらQ6へ上げる構成が現実的だ。
Q8_0は9.53GBなので実行余地はあるものの、KVキャッシュ、OS、ランタイム、画像encoderを加えると余白が小さくなる。
32GB RAMや12〜16GB VRAMでは選択肢が広がる。
導入では、まずllama.cppと信頼できるGGUFで短いコンテキストを試し、RAM/VRAM使用量とtok/sを測る。
その後にコンテキスト、画像入力、エージェント機能を増やせば、自分のPCでどこまで実用になるかを数字で判断できる。