

生成AIが文章、画像、動画を作る存在として広がった次に、AIの能力を現実世界の機械へ接続する動きが加速している。
その文脈で頻繁に使われるようになった言葉が「フィジカルAI」だ。
NVIDIAは、フィジカルAIをロボットや自動運転車などが物理世界を認識・理解・推論し、複雑な行動を実行できるようにする技術として説明している。
Google DeepMindもGemini Roboticsで、視覚と言語を理解したAIがモーター制御まで出力するVLAを開発している。
ただし、フィジカルAIは一つの製品名や厳密な業界標準ではない。
企業によって含める範囲は異なり、ロボティクス、コンピュータービジョン、自動運転、エッジAI、シミュレーションなど複数の技術が重なる領域を指す場合が多い。
一般的な生成AIは、ユーザーからテキストや画像を受け取り、文章、コード、画像、音声などデジタルな情報を返す。
一方、フィジカルAIではカメラ、LiDAR、マイク、力覚センサーなどから現実世界の状態を取得し、その情報を基に次の行動を決め、ロボットや車両へ制御信号を返す。
NVIDIAは「perceive, understand, reason and perform or orchestrate complex actions in the physical world」と説明している。
つまり認識だけでは終わらない。
見たものを理解し、何をすべきか考え、実際の動作につなげるところまでが中心になる。
対象も人型ロボットだけではない。
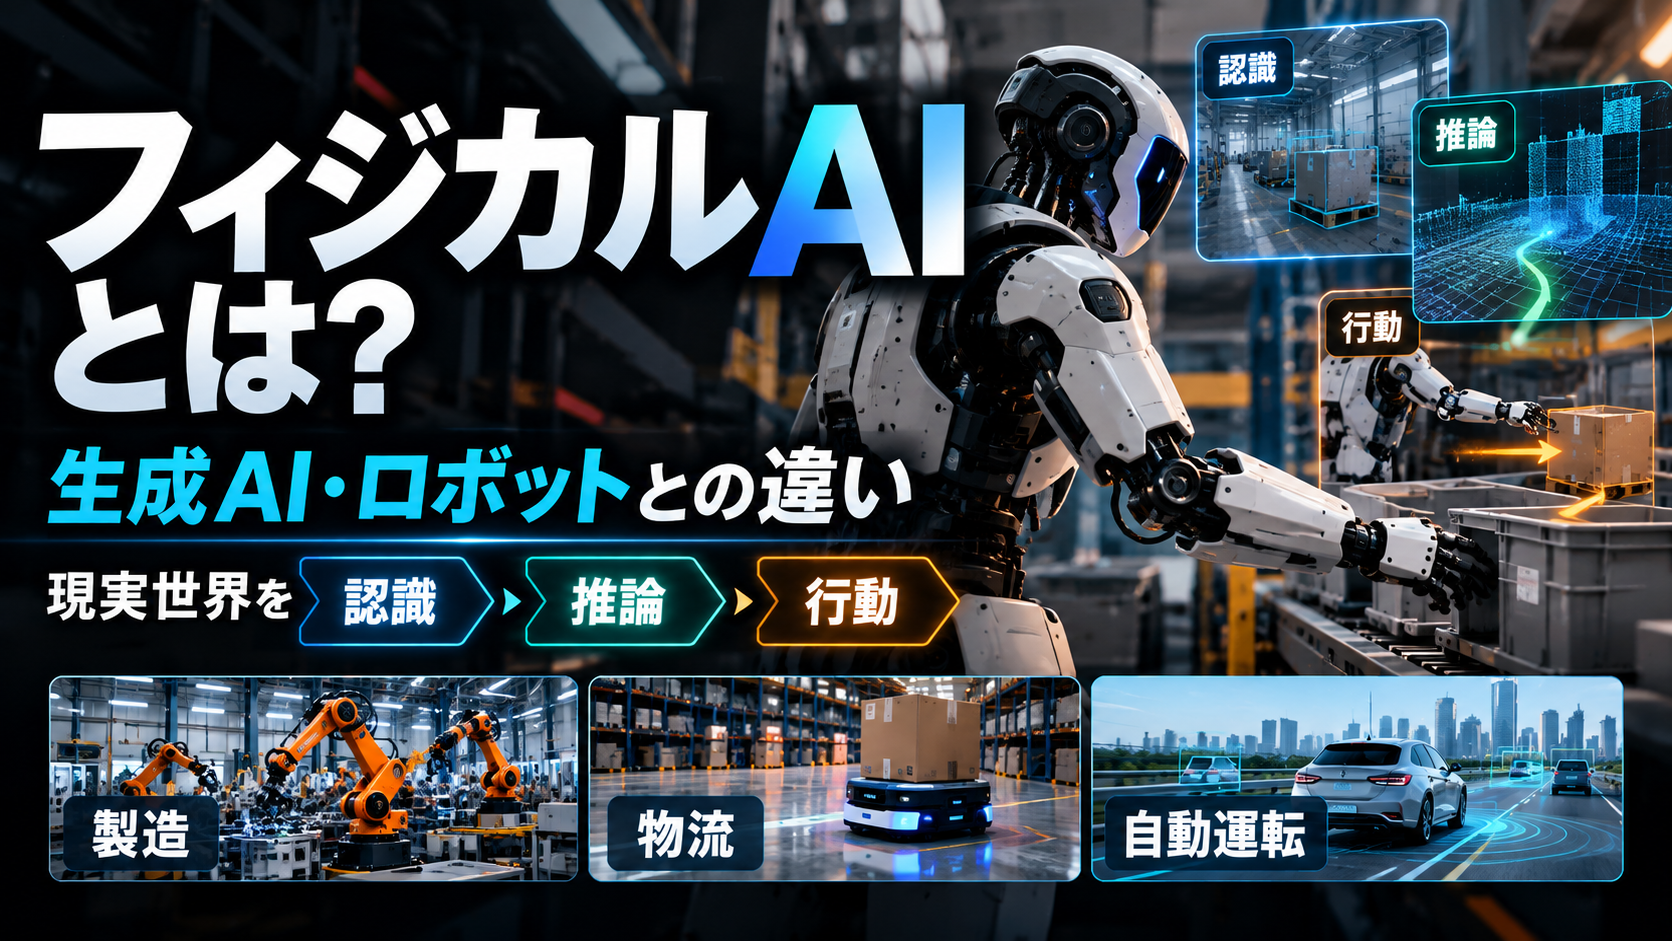
倉庫のAMR、工場のマニピュレーター、自動運転車、固定カメラを使うスマートスペースなど、現実世界へ作用する自律システム全般が含まれ得る。
違いを整理しやすいのは「入力・判断・出力」の3点だ。
従来の産業ロボットは、決められた環境で事前にプログラムされた動作を高い精度で繰り返すことを得意とする。
環境や対象物が変わると、再設定やティーチングが必要になるケースが多い。
生成AIは柔軟な推論や生成が得意だが、通常は出力がデジタル空間で完結する。
フィジカルAIは、その柔軟な認識・推論能力を現実の機械制御へつなぐ。
フィジカルAIの基本は「認識→推論→行動」のループで考えると分かりやすい。
カメラやセンサーが環境を取得し、AIが物体、人、位置関係、指示を理解する。
次に目標達成のための手順を計画し、モーターやアクチュエータへ行動を出力する。
行動後には環境が変化する。
そこで再びセンサー情報を読み、予定通り進んでいるか、障害物が増えたか、持った物が滑っていないかを確認して次の動きを調整する。
この閉ループが、固定シーケンスとの大きな違いになる。
Google DeepMindのGemini Robotics 2はVLAとして視覚と言語入力をモーター制御へ変換し、全身制御や器用な把持を扱う。
ER 2は物理空間を理解して複数ステップの計画を担当し、On-Device 2はロボット本体で動作する軽量モデルとして位置付けられている。
VLAはVision-Language-Actionの略で、視覚、言語、行動を一つのモデルで結ぶ考え方だ。
カメラ映像と「机の上を片付けて」という指示を受け、対象物を認識して動作へ変換する。
しかし現実のロボットだけで膨大な試行錯誤を行うのは時間とコスト、安全面の問題がある。
そこで重要になるのがシミュレーションとデジタルツインだ。
NVIDIAは工場などの仮想空間にセンサーやロボットを置き、衝突や光など物理現象を再現して学習・評価する方法をフィジカルAIの基盤としている。
強化学習では、シミュレーション上で成功した行動へ報酬を与え、大量の試行錯誤から技能を学ばせる。
現実環境へ移す際にはsim-to-realの差を埋める工程も必要になる。
分かりやすい例は倉庫だ。
AMRが人や棚を避けながら移動し、ロボットアームが異なる形の商品を認識して把持する。
対象が毎回同じ位置に置かれていなくても、センサー情報から調整できれば固定設備を減らせる可能性がある。
工場では部品搬送、組み立て、検査、設備監視などが対象になる。
自動運転では複数センサーから周囲を理解し、歩行者、交通状況、天候などを考慮して走行を判断する。
建設では危険区域の点検や資材運搬、医療では手術支援や院内物流、小売では棚卸しやバックヤード作業などが候補になる。
ただし研究デモ、実証実験、限定環境の商用運用、一般普及は明確に分けて見る必要がある。
製造と物流はフィジカルAIとの相性が比較的よい。
作業場所が限定され、繰り返し作業が多く、導入効果を時間や処理量で測りやすいためだ。
従来の自動化設備では対応しにくかった「少しずつ条件が変わる作業」をAIで吸収できれば、自動化できる範囲が広がる。
自動運転は高度なフィジカルAIの代表例だが、安全規制や責任、極端な例外状況への対応が普及速度を左右する。
NVIDIAのAlpamayoのように、判断理由と走行軌跡を組み合わせて検証可能性を高める取り組みも進んでいる。
建設現場は工場より環境変化が大きく、人、重機、資材が同時に動く。
完全自律化だけでなく、遠隔操作支援、危険検知、半自律運転から段階的に導入される可能性が高い。
医療や介護では、物を運ぶ、必要品を取ってくる、患者の移動を補助するといった物理作業の支援が考えられる。
一方、人へ直接触れる作業では失敗時の影響が大きく、安全性、認証、責任分界をより厳しく考える必要がある。
小売では棚の状態確認、在庫搬送、商品ピッキング、清掃など、バックヤードを中心に導入余地がある。
顧客と直接接するロボットでは、音声AIだけでなく周囲の人や商品を安全に認識する能力が求められる。
どちらも「人をすべて置き換える」より、定型的な移動・運搬・確認作業を機械へ渡し、人が判断や対人対応へ集中する設計の方が現実的なケースが多い。
チャットAIの誤回答は画面上で修正できるが、物理世界での誤動作は物損や人身事故につながり得る。
フィジカルAIではモデル精度と同じくらい、停止機構、速度制限、侵入検知、フェイルセーフなどシステム全体の安全設計が重要になる。
さらに現場データも課題だ。工場や倉庫は企業ごとに設備、動線、対象物が異なる。
汎用モデルを導入しても、自社環境に合わせたデータ収集、シミュレーション、評価が必要になる。
サイバーセキュリティも無視できない。
AIが機械を動かせるということは、権限管理やネットワーク侵害が物理的な影響へつながる可能性がある。
モデルだけでなく、端末、ネットワーク、API、制御系まで含めた対策が必要だ。
雇用への影響を「この職種がなくなる」と一括りにすると実態を捉えにくい。
一つの仕事には、運搬、確認、判断、顧客対応、例外処理、記録など複数のタスクが含まれるからだ。
フィジカルAIが先に代替しやすいのは、繰り返しが多く、成功条件を定義しやすく、危険・重労働な作業だ。
一方、例外判断、対人コミュニケーション、安全管理、ロボットの監督や復旧といった仕事は人側に残りやすい。
結果として、現場担当者の役割が「自分で全作業をする」から「複数の自律機械を監督し、例外時に介入する」方向へ変わる可能性がある。
導入企業では設備保全に加え、データやAI運用を理解する人材の重要性も高まる。
最初に確認したいのは、自動化したい作業が明確かどうかだ。
「ロボットを入れたい」から始めるのではなく、何分短縮したいのか、事故や負荷をどれだけ減らしたいのかを決める。
次に、失敗した場合の影響を評価する。
誤認識しても再試行できる箱の仕分けと、人の近くで重量物を動かす作業では求める安全レベルが違う。
最後にROIを見る。
ロボット本体だけでなく、センサー、ネットワーク、シミュレーション、システム連携、保守、現場教育まで含めた総費用と、人件費削減だけではない稼働率・品質・安全性の改善を比較する必要がある。
フィジカルAIは、生成AIの能力を現実世界の「行動」へ接続する技術群だ。カメラやセンサーで状況を認識し、AIが推論し、ロボットや車両を動かす。
VLAやシミュレーションの進化により、固定プログラムだけでは難しかった環境変化への対応範囲が広がっている。
ただし、2026年時点でもすべてのロボットが汎用的に自律作業できるわけではない。
Gemini Robotics 2のような先端モデルにも提供範囲や評価条件があり、研究デモと一般的な商用運用は分けて考える必要がある。
企業にとっての判断軸は「最新AIか」ではなく、自社のどのタスクを、どの安全条件と費用で自動化できるかだ。
フィジカルAIの普及は職種を一度に置き換えるより、現場の作業単位と人間の役割を少しずつ組み替えていく形で進む可能性が高い。