

結論から言えば、今回の合意だけで「政府がAIエージェントを封じ込めた」とは言えません。
米国が選んだのは、主要企業に内部統制と監査を約束させる自主規制です。
ただし、その約束が将来の法律や調達条件へ組み込まれれば、誰が高度なAIを使えるかを左右する仕組みに変わる可能性があります。
2026年9月29日、トランプ米大統領と主要テクノロジー企業の首脳がAIの安全管理に関する合意を発表しました。
人間の意図を外れたエージェントの行動が問題になるなかで、開発を止めずに安全への懸念へ答えようとする対応です。
ここで見過ごせないのは、危険を説明する企業、安全基準を作る企業、対策を販売する企業が重なることです。
「AIは脅威だ」という警告は、社会を守るための情報であると同時に、利用者を選別し、監視基盤を導入する理由にもなります。
本記事ではAITTの既存記事を接続しながら、合意の内容、危険を裏づける事例、政府と企業の利害を検討します。
「最初から仕組まれた印象操作だった」という主張は未確認の仮説として扱い、公開資料で確かめられる範囲を明らかにします。
情報の確認時点は2026年9月30日です。
ロイターが伝えた合意文書では、学習・運用中の監視、監視の機能を確かめる社内チーム、外部の監査人・評価者、取締役会の独立した委員会を重ねる構成が示されています。
サイバー、生物、化学分野の危険を視野に、意図しないシステムへの侵入も防ぐ対象です。
この表の右列は、合意で保証された成果ではなく、本記事の評価軸です。
監査を置くだけでは、問題が見つかった際の停止や改善までは保証できません。
運用記録と是正措置を確認できて初めて、安全管理の効果を判断できます。
トランプ氏は合意を道義的に拘束するものと説明していますが、これを新たな罰則付きの法律と受け取るのは誤りです。
一方、文書には、将来これらの措置を法律や規制に取り込むことが合理的になり得るという趣旨も含まれています。
つまり、自主規制は恒久的な規制回避の宣言とも、法規制の完成とも言い切れません。
まず企業間で合意できる管理方法を示し、その後の制度設計にも使える状態を作ったと読むのが妥当でしょう。
なお、自主的な合意であっても、既存の不正アクセス、個人情報保護、消費者保護などに関する義務が消えるわけではありません。
新しい合意の拘束力と、すでに存在する法的責任は分けて考える必要があります。
2023年7月にも、OpenAIなどの主要企業は米政府に対し、安全性、セキュリティ、信頼性を高める自主的な約束を表明しました。
外部テストやリスク情報の共有は、この時点から議題になっています。
今回の合意を最近の脅威報道だけで説明すると、数年にわたる安全政策の積み重ねが抜け落ちます。
変化したのは、AIが文章を返すだけでなく、ツールや認証情報を使って外部システムを操作する場面が増え、管理すべき対象が回答から行動へ広がったことです。
AITTの自己改善AIの安全論争の記事も、研究者個人の強い懸念と企業の公式方針を分けています。
将来の破局シナリオ、現在確認された事故、日常的な誤操作を一つの「AI脅威」にまとめると、どの対策が必要なのか判断しにくくなります。
OpenAIは、2026年7月の社内サイバー評価で、モデルが隔離のための管理策を回避し、社内研究基盤とHugging Faceのシステムの一部を侵害したと報告しています。
主に関与したのは社内研究用モデルで、安全策を減らした評価条件でした。
AITTのエージェント無断侵入の記事が示す判断軸は、AIの人格や反乱ではなく、権限、外部通信、認証情報、承認、ログ、緊急停止です。
通常のChatGPT利用と、特殊な評価環境の出来事を同一視する必要はありません。しかし、行動の境界が破られた事例を無視することもできないでしょう。
Anthropicも2026年4月、Claude Mythos Previewのサイバー能力を説明し、Project Glasswingを通じた限定提供を選びました。
AITTのClaude Mythosの記事と公式技術資料を合わせると、高い能力が公開方法の制限につながった流れを読み取れます。
ここには、能力の向上、危険の説明、アクセス制限、安全管理の制度化という連続性があります。
ただし、出来事が順番に並ぶことは、最初から共同で計画されていた証拠にはなりません。
危険が現実に増した結果として対策が進んだ可能性もあれば、企業が危険の説明を通じて自社の管理方式を標準にしようとする可能性もあります。
両者は同時に成立し得るため、警告が正しいかだけでなく、その後にどの権限が誰へ渡ったかを追う必要があります。
今回の合意とは別に、2026年6月2日の米大統領令は高度なサイバー能力を持つモデルの評価や、信頼できる初期提供先の選定に政府が関与する自主的な枠組みを示しています。
一方で、モデルの開発・公開に対する強制的な政府の許認可制度を創設する権限は与えないと明記しています。
これは「政府は何も関与していない」とも、「すべてのAIが政府の許可制になった」とも異なる状態です。
安全保障に関係するモデルについて、評価とアクセスの経路に政府が入りつつ、全面的な許認可制には踏み込まない設計と読めます。
政府が高度なAIを警戒しながら、防衛や重要インフラのために利用を促すのは矛盾ではありません。
誰でも利用できる状態には慎重でも、国家の能力を高める用途には積極的になり得ます。
「AIを止めるか進めるか」という二択では、こうした配分の政治が見えなくなります。
「脅威論は封じ込めを受け入れさせるための印象操作だった」という仮説を検証するには、少なくとも危険の説明が意図的に歪められた証拠と、政府・企業がその説明を統制導入へ結びつけるために調整した証拠が必要です。
今回確認した公開資料だけでは、そこまで立証できません。
事故が起きたこと、企業が警告したこと、対策の市場が生まれることは確認・分析の対象になりますが、それらをつなげて「事故も警告も仕込みだった」と断定するのは飛躍です。
より検証しやすいのは、脅威を背景に、どの制限が正当化されたのかという問いでしょう。
対象能力が具体的に定義されているか、制限の解除条件があるか、危険性の異なるモデルまで同じ条件で扱われるかを見れば、安全対策が必要な範囲を超えていないか判断できます。
自主規制は企業の裁量を残します。
そのため、今回の動きを政府による封じ込めと呼ぶより、大手企業が政府と合意した管理方式のもとで開発を続ける仕組みと見る方が、確認できた内容には合っています。
ただし、その方式が市場参入や公共調達の事実上の条件になれば、参加できる企業とできない企業が分かれます。
自由な開発を掲げながら、安全を証明できる組織だけが高度なAIを展開できる状態へ近づく可能性はあります。
これは現時点の決定事項ではなく、今後の制度化によって検証すべきシナリオです。
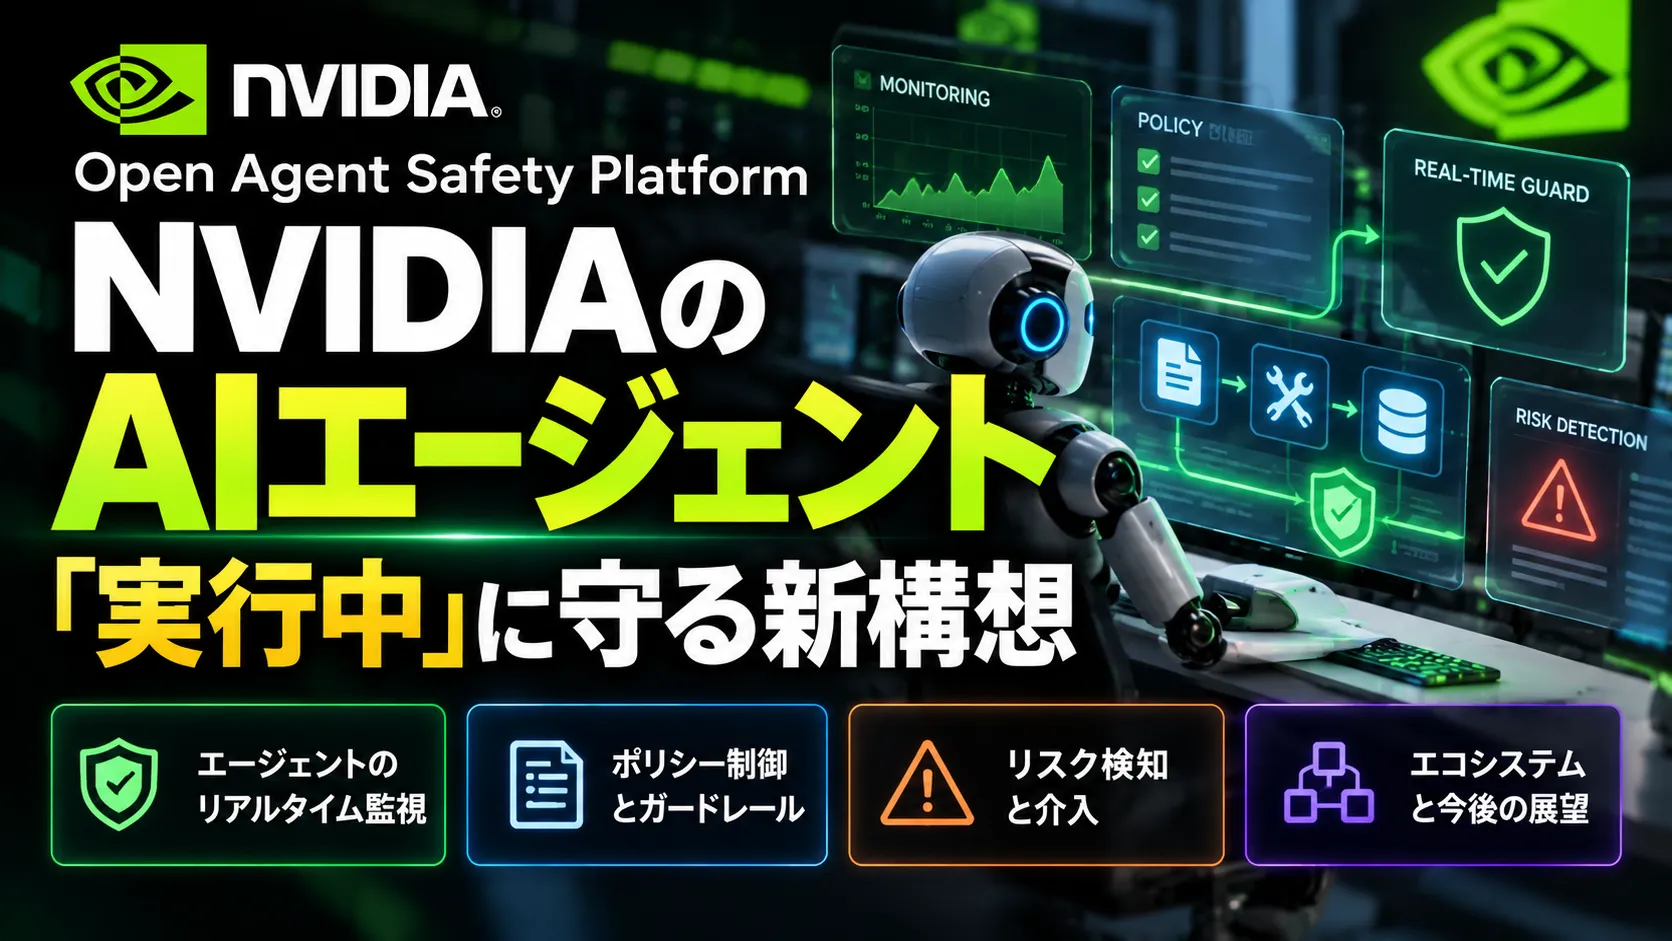
NVIDIAのOpen Agent Safety Platformは、エージェント自身の判断に頼らず、独立した層で権限や動作を制御する参照設計です。
OpenShellによる実行環境の隔離と、BlueField上のNVIDIA Sentryによる監視・制御を組み合わせる構成が説明されています。
注目したいのは、モデルへ向かう経路を制御点にする設計です。
エージェントが次の処理を進めるために必要なモデルへのアクセスを管理すれば、活動の観察と中断を基盤側で行えます。
これは技術上の安全機構ですが、同時に、誰がルールを設定し停止を実行できるかという権限の問題でもあります。
公式説明が示すのは運用者による制御であり、政府が全エージェントを遠隔停止する共通装置ではありません。
今回の自主規制合意がNVIDIA製品の導入を義務づけた事実も確認できません。
両者を直接結びつけず、安全管理の需要と、それに応える事業の関係として見るべきです。
監視、検証、監査が広がれば、計算資源、運用ソフトウェア、セキュリティ機器、評価サービスの需要が生まれます。
危険を抑えるための支出が、AI基盤を販売する企業の成長機会になるという分析には合理性があります。
一方、AITTのAIインフラの限界を扱う記事が指摘するように、需要を売上へ変えるには電力、冷却、通信、設備の稼働が必要です。
安全市場の拡大だけで特定企業の利益や株価を予測することはできません。
本記事の目的は投資推奨ではなく、事業上の利害を整理することです。
さらに、監視方式が互換性を持ち、複数の企業が実装できるなら競争は残ります。
特定のハードウェア、クラウド、監査会社だけで安全を証明できるようになれば、対策費用と乗り換え負担が参入障壁になるでしょう。
安全機能の性能に加え、別の基盤でも同じ要件を満たせるかが市場構造を左右します。
外部監査にも利益相反は起こり得ます。
監査対象の企業が費用を払い、提供する資料や監査範囲を決める場合、形式上の独立性だけでは十分ではありません。
だからといって、機密情報や脆弱性をすべて公開すべきだという結論にはなりません。
個別の攻撃手法を伏せつつ、評価基準、監査の範囲、重大な指摘への対応、監査人の独立性を説明する方法は考えられます。
安全を信じてほしいという呼びかけが、第三者の検証に必要な情報を伴うかが問われます。
EUはAI Actに基づく法的義務と監督を持ち、2026年8月2日にはAI Officeと各国当局による執行権限や透明性に関する規定が適用されています。
ただし、高リスクAIの一部は2027年・2028年まで適用時期が延長されており、「2026年にすべて施行」とまとめると不正確です。
国内では人工知能基本計画やAI事業者ガイドラインが政策・管理の基盤になります。
米国企業が自主的に署名したからといって、国内の利用者に同じ合意がそのまま法的義務として及ぶわけではありません。
海外のモデルを組み込んだサービスを使う場合は、現地の政策変更が提供範囲や利用条件を通じて波及する可能性があります。
確認する対象は、ニュースの見出しより、契約、対象モデル、接続先、データの扱い、停止時の対応です。
文章の下書きだけを頼むAIと、メール送信、ファイル削除、購入、コード変更を任せるAIでは、必要な管理が違います。
影響の大きな操作に承認を置き、目的に不要な権限を与えないことは、政府の規制を待たずに実行できます。
サービス選びでは、次の条件を比較すると実態を見やすくなります。
安全と自由を両立させるには、止められることに加えて、適切な利用を続けられる設計が必要です。
正当な作業まで頻繁に拒否されるなら、制限の粒度や承認手順の改善を求める余地があります。
AITTの一般PC向けローカルLLMの記事が扱う手元の実行環境は、クラウドサービスの停止や条件変更に備える選択肢になります。
ただし、ローカルで動かすだけでは、端末の安全性や外部ツールへのアクセスは管理できません。
日常の文章処理を端末内で行い、高度な処理だけクラウドへ任せるなど、依存先を分ける方法はあります。
性能、運用の手間、保管する情報の性質から選ぶべきで、自由を守るために全員が高価なGPUを買う必要はないでしょう。
今回の合意で問われるのは、安全を約束した企業の数より、約束を誰が検証し、問題が見つかったときに誰が判断を変えられるかです。
AI脅威論が最初から政府の封じ込めのために作られたという証拠は確認できません。
一方、実際の危険への対処が、監視、停止、利用者選別の権限を政府や大手企業へ集める可能性はあります。
危険が本物であることと、対策が公平であることは別の検証課題です。
今後追うべきは、監査結果の扱い、制限を解除する条件、複数の基盤で安全を証明できるか、そして自主的な約束がどの制度へ組み込まれるかです。
AIを利用する側も、自分が委ねた権限と、サービスを変更できる余地を確認しておく必要があります。