

Whisperなどを使えば会議音声を高精度に文字起こしできる。
しかし3人、4人と参加者が増えると、「この発言は誰のものか」が分からない議事録になりやすい。
そこで使われるのがSpeaker Diarization、つまり話者分離だ。
NVIDIAのNeMo Speechでは、Sortformerを使って音声の時間軸に話者ラベルを付けられる。
リアルタイム処理向けのStreaming Sortformerと、録音後にまとめて処理するOffline Sortformerが用意されている。
ここで注意したいのは、話者分離と文字起こしは別工程だという点だ。
Diarizationだけでは発言内容はテキストにならない。
ASRと組み合わせて初めて「誰が、何を話したか」を扱える。
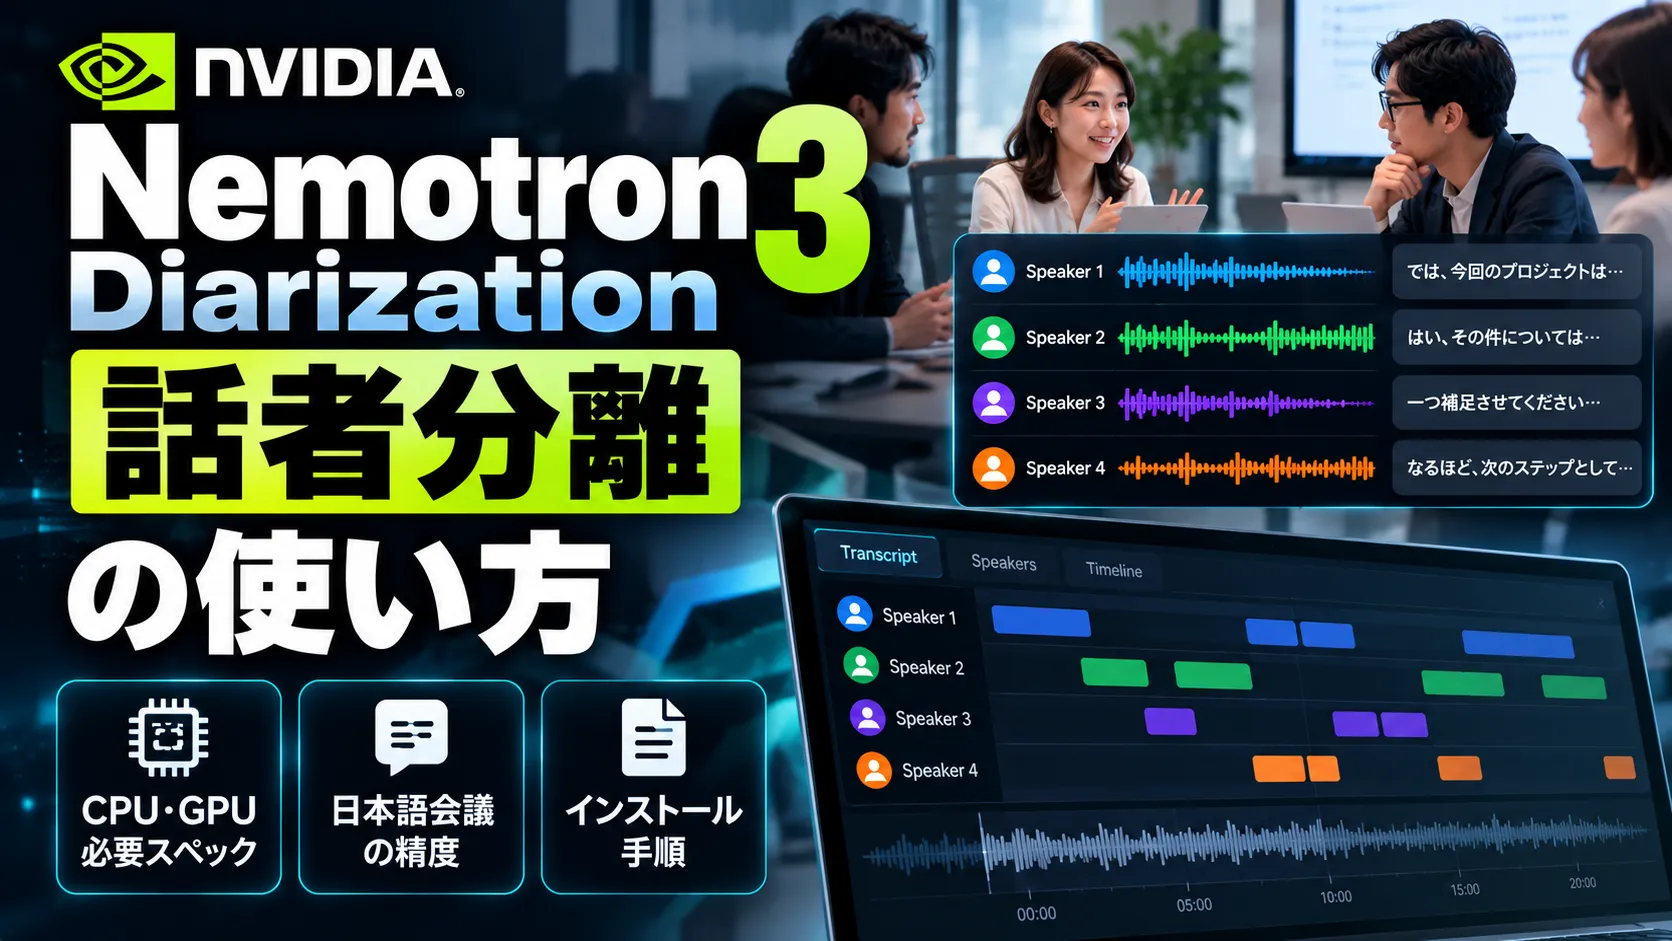
Nemotron 3 Diarizationは、NVIDIAが公開した「誰がいつ話したか」を推定する音声モデルです。
録音ファイルの処理とストリーミング推論に対応し、最大8話者を扱います。
発言内容を文字にするモデルではないため、話者付きの文字起こしを作るには、ASRと呼ばれる音声認識モデルを組み合わせます。
ASRは「何を話したか」を文字へ変換する。
一方、Diarizationは「いつ、誰が話したか」を推定する。同じ音声を入力しても出力の目的が違う。
実務では両方を統合する。
たとえばASRが「次の施策は来週決めます」と文字化し、Diarizationがその時間帯をspeaker_2と判定すれば、「Speaker 2:次の施策は来週決めます」という形にできる。
Nemotron 3 Diarizationは最大8話者に対応しています。
一方、旧モデルの「diar_streaming_sortformer_4spk-v2.1」は4話者対応です。
旧モデルや、それを利用したVoice Agentの仕様を、Nemotron 3 Diarizationの制限として扱わないようにしてください。
ただし、最大8話者対応は、8人の会議を常に正確に識別できるという意味ではありません。
似た声、短い相づち、同時発話、録音環境によって話者の取り違えが起こり得ます。
出力される話者ラベルは、参加者の実名ではありません。
議事録に名前を付ける場合は、録音と照合してラベルと参加者を対応付けます。
NVIDIAのVoice Agent標準設定はdeviceにcudaを使う。
ASRとDiarizationが同じdevice設定を共有するため、リアルタイム音声エージェント用途ではCUDA GPUを前提にした構成が分かりやすい。
一方、録音ファイルを後処理する用途ではリアルタイム性が必須ではない。
CPU実行可能なランタイムやコミュニティ実装を使える場合、GPUなしでも処理できる可能性はあるがNVIDIA公式の特定GPU測定値を一般CPUへそのまま換算してはいけない。
必要スペックは「モデルが読み込めるか」より、音声1分を何秒で処理したいかで決める。
会議終了後に数分待てるならCPUも候補になるが、会話中にspeaker tagを付けたいならGPUの優先度が上がる。
Nemotron 3 DiarizationをNeMo Speechで実行するには、対応するPython・PyTorch・NeMo Speech環境を用意します。
以下は、録音済みの音声ファイルから話者区間を取得するコード例です。
環境構築後に実行してください。
なお、このコードは公式の使用例に基づくもので、本記事での動作検証は行っていません。
from nemo.collections.asr.models import SortformerEncLabelModel

model = SortformerEncLabelModel.from_pretrained(
    "nvidia/Nemotron-3-Diarization"
)
model.eval()

# 録音ファイル向けの設定例
model.sortformer_modules.chunk_len = 340
model.sortformer_modules.chunk_right_context = 40
model.sortformer_modules.fifo_len = 40
model.sortformer_modules.spkcache_update_period = 300
model._check_streaming_parameters()

results = model.diarize(
    audio=["meeting.wav"],
    batch_size=1
)

for segment in results[0]:
print(segment)meeting.wavは、処理したい16kHz・モノラルの音声ファイルに置き換えてください。
初回実行時にはモデルをダウンロードするため通信が発生します。
音声を外部APIへ送らず処理したい場合は、組み合わせる文字起こし側もローカルで実行してください。
録音済み会議ではリアルタイムモデルにこだわる必要はない。
NVIDIAは「Determine who spoke when」の用途にStreaming SortformerとOffline Sortformerを推奨し、リアルタイムならstreaming、バッチならofflineと使い分けている。
基本フローは、音声ファイルの前処理→Diarization→ASR→タイムスタンプ統合だ。
Diarizationの区間とASRの単語・文タイムスタンプを突き合わせ、各発言へspeaker labelを付ける。
動画制作者なら、この出力を字幕生成へ流用できる。
ポッドキャストなら出演者別の発言時間集計などにも展開できる。
話者分離では、発言区間の開始時刻・終了時刻・話者ラベルを取得します。
次は仕組みを説明するための架空の例です。
実際の出力形式は、利用するツールによって異なります。
この段階では、発言内容の文章はありません。
Whisperなどで取得した文字起こしの時刻と照合すると、各発言に話者ラベルを付けられます。
例えば、3.4〜6.8秒の文字起こしが「資料は明日共有します」であれば、「speaker_1:資料は明日共有します」という形に整理できます。
話者交代をまたぐ長い文字起こし区間は、途中で分割するか、単語単位のタイムスタンプを使って対応付けます。
同時発話を含む箇所は、単純な時刻の照合だけでは誤って割り当てる場合があるため、録音を聞いて確認してください。
リアルタイム処理では短い音声を逐次モデルへ渡す。
Voice Agentの標準実装ではraw frameが16msで届き、80ms単位へまとめてモデルを呼び出す。
短いバッファは反応を速くできる一方、話者を判断する音声情報が少なくなる。
長く取れば判断材料は増えるが、speaker labelが確定するまでの遅延が増える。
会議用途では「最小遅延」を目指すより、誤って話者が頻繁に切り替わらない範囲でバッファを調整する方が実用的だ。
Whisperやfaster-whisperは発言内容を文字へ変換する役割を担当し、Sortformerは話者区間を担当する。
両方がタイムスタンプを持てば統合できる。
実装では、ASRセグメントの開始・終了時刻とDiarizationの話者区間の重なりを計算し、最も長く重なる話者を割り当てる方法が分かりやすい。
単語タイムスタンプを使えば、発言途中で話者が変わるケースも細かく処理できる。
LLMへ渡す前に「speaker_0」「speaker_1」のラベルを実名へ対応付ければ、会議要約、決定事項、担当者別ToDoの抽出まで自動化しやすくなる。
Diarizationは音声の言語内容そのものより声の特徴や時間構造を扱うため、ASRほど「日本語モデルか」が直接の条件にはなりにくい。
ただし、日本語会議で高精度だと無条件に断定することもできない。
アクセント、似た声質、短い相づち、重なり発話、会議室の反響、遠いマイクなどで誤認識が増える可能性がある。
NVIDIAのVoice Agentドキュメントもノイズや似た声で混同しやすい点を明記している。
導入前には実際の会議室、マイク、参加人数で録音し、DERだけでなく「議事録を人が直す時間がどれだけ減るか」を測るとよい。
機密会議では、音声そのものが重要情報になる。
ローカルDiarizationとローカルASRを組み合わせれば、音声を外部APIへ送らずに処理できる構成を作れる。
ただし「ローカルだからプライバシー問題がなくなる」わけではない。
録音ファイルの保存場所、アクセス権、バックアップ、削除期限、モデルが生成した議事録の共有範囲まで設計する必要がある。
クラウドストレージへ自動同期するPCなら、処理自体がローカルでも録音ファイルが外部へアップロードされる可能性がある。
モデルの利用条件は使用するチェックポイントごとに確認する。
NVIDIAのモデルカードに記載されたライセンスだけでなく、NeMo、ASR、周辺ライブラリのライセンスも企業利用では記録しておきたい。
会議録音では技術的に録音できることと、録音してよいことは別問題だ。
社内規程、就業規則、取引先との秘密保持、個人情報の扱いを確認し、必要に応じて参加者へ録音・AI処理を伝える。
特に顧客相談、採用面接、医療・金融などセンシティブな情報を含む場面では保存期間と利用目的を明確にすることが重要になる。
NVIDIAのSpeaker Diarizationを使うと、Whisperだけでは不足しがちな「誰が話したか」を会議音声へ追加できる。
文字起こしと話者分離を別工程として考えることが、最初のポイントだ。
Nemotron 3 Diarizationは最大8話者に対応し、録音ファイルの処理とストリーミング推論に利用できます。
旧Sortformerの4話者モデルや、それを利用したVoice Agentの仕様とは区別してください。
参加人数だけでなく、同時発話や録音環境を含めて精度を確認しましょう。
ローカル処理の価値は、音声を外へ出さず議事録を作れることにある。
まず実際の会議音声で話者精度と処理速度を測り、その後Whisperなどと統合する方が失敗しにくい。