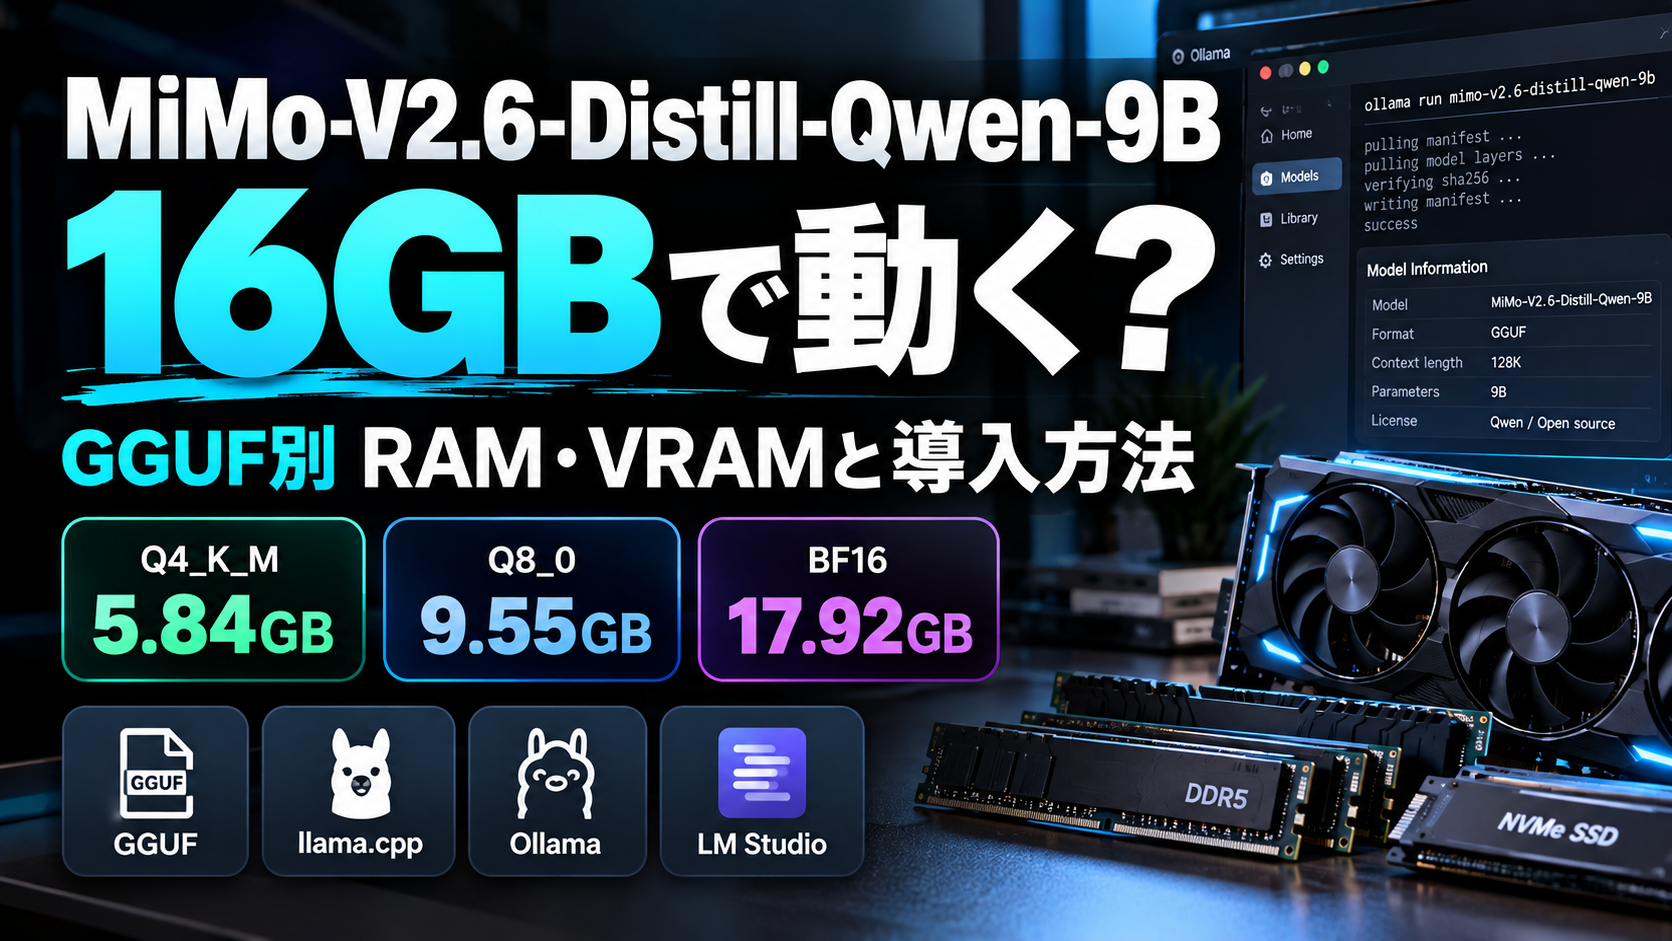


MiMo-V2.6-Distill-Qwen-9Bという名前を見ると、「Qwen3.5-9Bを軽くしたモデルなのか」「同じ9Bなら上位互換なのか」と迷いやすい。
だが、比較の中心を必要VRAMだけに置くとこのモデルの狙いを見落とす。
XiaomiMiMoの公式リポジトリではMiMo-V2.6-Distill-Qwen-9BはQwen3.5系の9Bモデルを基盤にしたImage-Text-to-Textモデルとして公開され、タグにはagentic distillation、supervised-fine-tuning、code、tool-useが付いている。
一方、Qwen公式のQwen3.5-9BもImage-Text-to-Textモデルで、画像と言語を同じモデルで扱える。
つまり比較したいのは「画像対応かどうか」ではない。
同じ土台に近いモデルが、ポストトレーニングによってどの仕事へ寄せられているかだ。
MiMo-V2.6-Distill-Qwen-9BはXiaomiのMiMoチームが公開した9B級モデルだ。
Hugging Face上ではqwen3_5、mimo_v2、agentic distillation、supervised-fine-tuning、code、tool-useと分類されている。
ここで「Distill」を単純な小型化と捉えない方がよい。
すでに9B級のQwenを土台にしながら、MiMo側の教師データやエージェント向けタスクを使って能力を寄せた派生モデルとして見る方が実態に近い。
そのためQwen3.5-9Bとパラメータ規模が近くても回答の傾向、コード修正、ツール呼び出し、長いタスクの進め方で差が出る可能性がある。
ハードウェア要件を劇的に軽くするためのモデルではなく用途適合を変えるモデルだ。
Qwen3.5-9Bの公式モデルはImage-Text-to-Textとして公開され、Transformers、vLLM、SGLang、Docker Model Runnerなどから利用できる。
モデルファイル一式は約19.3GBで、BF16重みは4分割されている。
MiMo版も同じQwen3.5系アーキテクチャを使うため、ローカル運用で必要になるメモリの桁は大きく変わらない。
MiMoだから9Bが突然4B相当のメモリで動くわけではない。
コード生成で重要なのは、短い関数を一発で書けるかだけではない。
実務ではリポジトリを読み、複数ファイルを変更し、テストを実行し、失敗したら原因を探して修正する。
エージェント型コーディングでは、この一連の手順を崩さず進められるかが重要になる。
MiMo版は公式タグやモデル説明からもcodeとagentic用途を前面に出している。
したがって、比較するならHumanEvalのような短い問題だけでなく、SWE系、ターミナル操作、複数ステップのコード修正を見る必要がある。
ただしMiMo側の公式評価値を、そのまま自分の開発環境へ当てはめることはできない。
使用するツール定義、システムプロンプト、推論設定、量子化によって結果は変わる。
Qwen3.5-9Bから切り替える場合は、自分が日常的に使うリポジトリで同じ10〜20タスクを走らせる方が判断材料になる。
両モデルともImage-Text-to-Textとして公開されているため、MiMoを「画像対応版Qwen」と説明するのは不正確だ。
Qwen3.5-9B自体が画像入力に対応している。
差が出るとすれば、画像を見た後に何をさせるかだ。
たとえばUIのスクリーンショットから問題箇所を特定し、その後コードを直すvisual codingでは視覚認識だけでなく推論と行動の連携が必要になる。
画像の説明精度だけを比べるテストでは、エージェント向け追加学習の価値を捉えにくい。
画面理解→操作計画→ツール利用まで一続きに評価したい。
ツール利用では正しい関数名を出せるかだけでなく、いつ検索し、いつコードを実行し、どの結果を次の判断へ使うかが重要だ。
MiMo版が狙う差はこの部分にある。
Qwen3.5-9Bは汎用モデルとして幅広い用途へ使いやすく、周辺ツールやドキュメントも揃いやすい。
一方、MiMo版はエージェント処理へ寄せたポストトレーニングによって、コード修正やツール連携のような連続タスクを重視している。
すでにQwen3.5-9Bで単発チャット、要約、一般的な画像質問が安定しているなら、置き換える理由は弱い。
逆にローカルのコーディングエージェントや業務エージェントを作っているなら、同一ハードウェアでMiMo版をA/Bテストする価値がある。
ローカル運用ではQ4、Q6、Q8などへ量子化することが多い。
ここで注意したいのは、BF16で確認されたモデル間の差が、強い量子化後にも同じ割合で残るとは限らないことだ。
量子化による影響はタスクによって異なる。
一般会話では差が小さくても、長いコード編集やツール呼び出しのJSON生成では失敗率が変わる可能性がある。
MiMoとQwenを比較するなら、片方だけQ4、もう片方をQ8にするのではなく、同じ量子化方式、同じコンテキスト、同じランタイム、同じプロンプトで評価する。
日本語性能も公式英語ベンチから推測せず、実際の日本語指示で確認したい。
Qwen3.5-9Bの公式ページではTransformersやvLLMを含む複数の導入経路が案内されている。
MiMo版もQwen3.5系なので、サーバー運用ではvLLMやSGLang、デスクトップではGGUF系ランタイムが候補になる。
サーバーで複数ユーザーからAPIアクセスさせるなら、vLLMやSGLangのスループットやバッチ処理が重要になる。
個人PCで1人が使うなら、llama.cpp系やLM StudioなどGGUFを扱いやすい環境の方が導入は簡単だ。
ただし派生モデルはランタイム側の対応が追いつくまで時間差が生じることがある。
モデルを読み込めるだけでなく、画像入力、チャットテンプレート、ツール呼び出しが正常かを個別に確認する必要がある。
必要VRAMの詳細は既存のMiMo-V2.6必要スペック記事で扱っているため、ここでは比較に必要な点だけ整理する。
両方とも9B級なので、同じ量子化なら大きなハードウェア差は生まれにくい。
8GB VRAMではQ4系を中心に検討し、余った部分をKVキャッシュや画像処理へ残す。
16GB VRAMならQ6やQ8を含め選択肢が増えるが、長いコンテキストや画像入力では追加メモリが必要になる。
モデル選択を「MiMoの方が軽いから」にしないことが大切だ。
同じPCで両方を同条件で走らせ、目的のタスクで成功率、速度、メモリ使用量を比較する方が合理的である。
Qwen3.5-9Bを一般チャット、翻訳、要約、画像質問に使っていて不満がないなら、MiMoへ急いで置き換える必要はない。
汎用モデルとしての安定した周辺環境も価値だからだ。
MiMo版を優先して試したいのは、ローカルのコーディングエージェント、ターミナル操作、ツール呼び出し、UI画像を見ながらコードを修正するワークフローを作っている人だ。
同じ9B級で追加学習の方向が自分の用途と合えば、ハードウェアを増強せず改善できる可能性がある。
最終判断はベンチマーク順位ではなく、自分の10〜20個の実務タスクで成功率を比較すること。
9Bモデルの選択では、数ポイントの総合スコアより、毎日使う作業で失敗しないことの方が価値が大きい。
MiMo-V2.6-Distill-Qwen-9Bは、Qwen3.5-9Bを単純に置き換える「上位版」と考えるより、同じ9B級の土台をエージェント、コード、ツール利用へ寄せた選択肢として見る方が分かりやすい。
両方とも画像入力を扱え、ローカル実行時のモデル規模も近い。
差を見たいなら必要VRAMではなく、コード修正、ツール実行、visual coding、長い手順の維持といったタスクで比較する。
Qwen3.5-9Bが現在の用途で安定しているなら継続する合理性がある。
一方、エージェント型の作業が中心ならMiMo版を同条件で試し、成功率が改善するか確認する。
この比較方法なら、モデル名やベンチ順位に引っ張られず、自分の環境に合う方を選べる。